Bir sunucunun öğrendiği haberi rastgele birkaç komşusuna söylediğini, onların da aynı şeyi başkalarına aktardığını düşünün. Bir süre sonra bütün ağ haberdar olur; üstelik ortada süreci yöneten bir merkez yoktur. Dağıtık sistemlerde bu modele gossip, yani dedikodu protokolü denir. İnsan topluluklarında bazen baş ağrıtan dedikodu, bilgisayar ağlarında ölçeklenebilirlik ve arıza toleransı sağlayan son derece kullanışlı bir mekanizmadır.
Devamı...
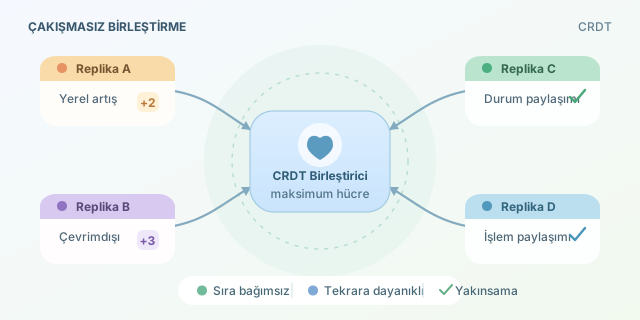
İki kullanıcının çevrimdışı çalışırken aynı belgeyi değiştirdiğini düşünün. İnternet geri geldiğinde hangi sürüm kazanmalı? Birini seçmek veri kaybına, her değişikliği sırayla işlemek ise koordinasyon maliyetine yol açabilir. CRDT (Conflict-free Replicated Data Type), farklı kopyalarda yapılan eş zamanlı değişikliklerin merkezi bir hakeme ihtiyaç duymadan güvenli biçimde birleştirilmesini sağlayan veri yapıları ailesidir.
Devamı...
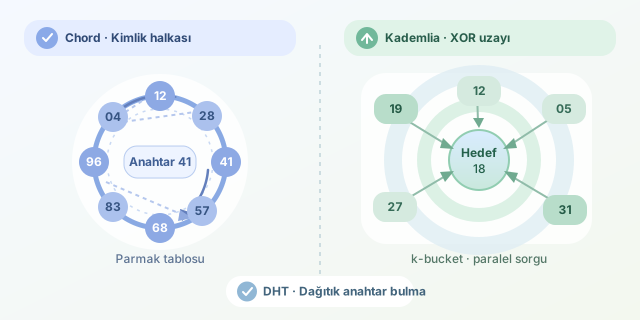
Merkezi bir veritabanı olmadan milyonlarca anahtarın hangi bilgisayarda tutulduğunu bulabilir miyiz? Dağıtık Hash Tabloları, yani DHT’ler, tam olarak bu problemi çözer. Chord ve Kademlia ise aynı hedefe farklı rotalardan giden iki meşhur protokoldür: Biri düğümleri halka üzerinde yürütür, diğeri XOR uzaklığıyla dijital bir pusula kullanır.
Devamı...
Bir veritabanı tasarlarken yalnızca “Veriyi nereye kaydedelim?” diye sormak yetmez; verinin nasıl okunacağını ve yazılacağını da düşünmek gerekir. B-tree ile LSM-tree arasındaki seçim tam olarak bu noktada karşımıza çıkar. B-tree genellikle dengeli ve hızlı okumalarıyla öne çıkarken LSM-tree yoğun yazma trafiğini sıralı işlemlere dönüştürerek depolama aygıtını mutlu eder. Kısacası biri düzenli bir kütüphaneci, diğeri masasına gelen belgeleri önce hızlıca kutulayan enerjik bir arşivcidir.
Devamı...
Bir robotun başlangıç noktasından hedefe gitmesi kolay görünebilir; ta ki odanın ortasına sandalye, kutu ve duvarlar yerleştirene kadar! Robotik yol planlamanın amacı, hareketli sistemi engellere çarptırmadan hedefe ulaştıracak mümkün olan en düşük maliyetli rotayı bulmaktır. A* algoritması, gerçek maliyet ile hedefe yönelik tahmini birleştirerek bu işi hem verimli hem de anlaşılır biçimde yapar.
Devamı...
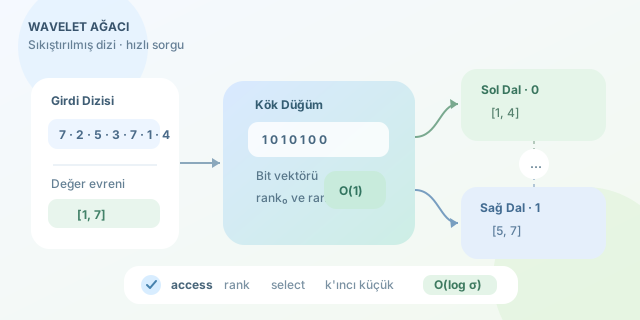
Büyük bir sayı dizisini hem az yer kaplayacak biçimde saklamak hem de üzerinde hızlı sorgular çalıştırmak kulağa iki ayrı hedef gibi gelir. Wavelet ağacı, bu hedefleri aynı veri yapısında buluşturur. Özellikle metin indeksleme, genom analizi, coğrafi veriler ve analitik sistemlerde; bir aralıktaki k’ıncı küçük elemanı ya da belirli bir değerin kaç kez geçtiğini etkileyici hızlarda bulabilir.
Devamı...
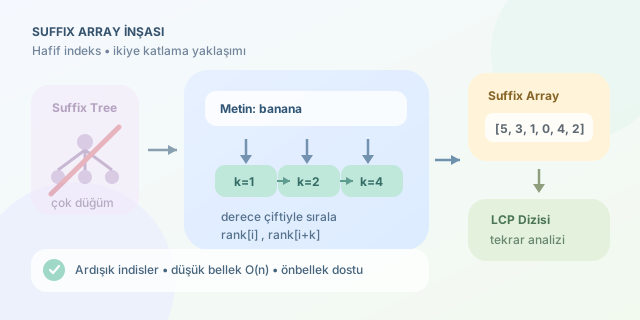
Bir metin içinde desen aramak, tekrarları bulmak veya sözlük sırasına göre son ekleri incelemek istediğimizde suffix tree güçlü bir çözümdür. Ancak düğümler, bağlantılar ve yüksek bellek tüketimi yüzünden uygulaması biraz “orman yangınına” dönüşebilir. Suffix array ise aynı fikirlerin önemli bir bölümünü yalnızca bir tamsayı dizisiyle sunar: Daha sade, önbellek dostu ve pratik!
Devamı...
Dinamik programlamada durum değişkeni bir sayı olduğunda, her olası değeri ayrı ayrı tutmak çoğu zaman pahalıdır. Slope trick, parçalı doğrusal dışbükey bir DP fonksiyonunu değerleriyle değil, eğiminin değiştiği noktalarla temsil eder. Böylece devasa bir koordinat aralığı, birkaç öncelik kuyruğu ve şaşırtıcı derecede az kodla yönetilebilir.
Devamı...
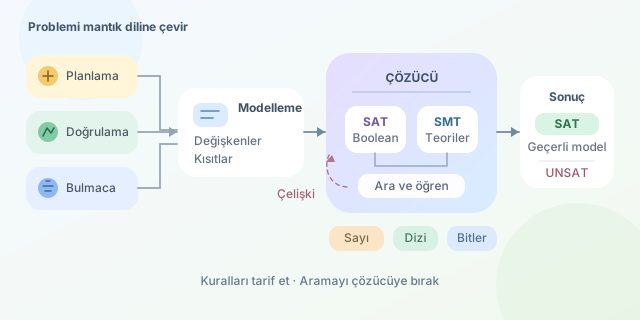
Bir sudoku çözmek, işlemci devresini doğrulamak veya çalışanların vardiyalarını planlamak ilk bakışta tamamen farklı problemlerdir. SAT ve SMT çözücüleri ise bu karmaşanın karşısına aynı soruyla çıkar: “Verilen bütün kuralları aynı anda sağlayan en az bir değer ataması var mı?” Problemi bu dile çevirebilirsek çözüm arama işini son derece gelişmiş algoritmalara bırakabiliriz.
Devamı...
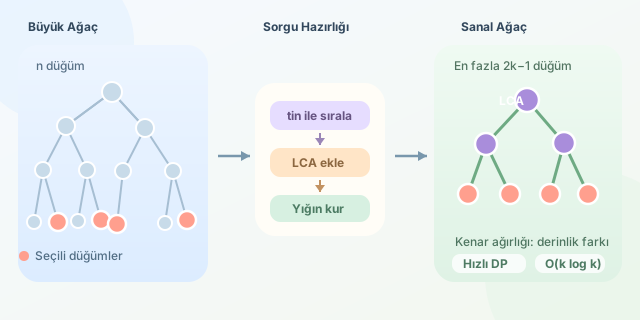
Büyük bir ağaçta yalnızca birkaç seçili düğümle ilgilendiğinizi düşünün. Milyonlarca düğümü her sorguda dolaşmak, çay demlenene kadar çalışan algoritmalar üretir. Sanal ağaç (virtual tree) ise yalnızca önemli düğümleri ve bunların bağlantısını koruyarak sorguyu küçük bir ağaca indirger.
Devamı...
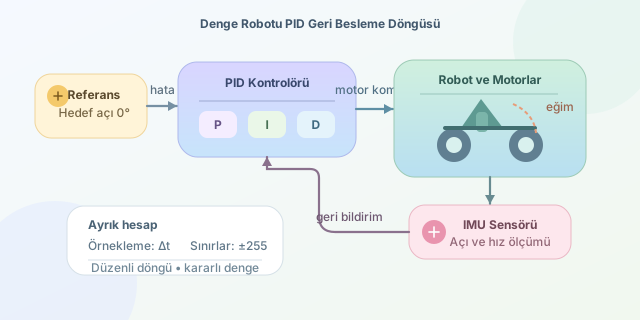
İki tekerlek üzerinde duran bir robotu, parmağınızın ucunda dik tutmaya çalıştığınız süpürgeye benzetebilirsiniz. Robot biraz öne eğildiğinde tekerleklerini öne sürmeli, fazla hızlandığında ise geri çekmelidir. Bu kararların hızlı, ölçülü ve sürekli alınmasını sağlayan matematiksel kahraman PID kontrolörüdür.
Devamı...
Bir segment tree düşünün: aralık toplamlarını hızla hesaplıyor, güncellemeleri şıp diye uyguluyor ama her değişiklikte eski hâlini unutuyor. Persistent segment tree ise biraz nostaljiktir; yapılan her güncellemeden sonra geçmiş sürümleri saklar. Böylece yalnızca güncel veriye değil, dizinin herhangi bir zamandaki hâline de erişebiliriz.
Devamı...
Bir dizide yüzlerce kez “$[L,R]$ aralığında kaç farklı sayı var?” diye sorulduğunu düşünün. Her sorguyu baştan sona taramak doğru sonucu verir; fakat büyük verilerde işlemci kısa sürede maraton koşmuş gibi yorulur. Mo algoritması, sorguların sırasını değiştirerek mevcut aralığı küçük adımlarla günceller ve bu tekrarları ciddi ölçüde azaltır.
Devamı...
Bir ağaçta kenarlar sürekli eklenip çıkarılıyorsa klasik DFS yaklaşımı kısa sürede nefes nefese kalır. Link-cut tree, düğümler arasındaki yolları sorgularken ağacın bağlantılarını dinamik biçimde değiştirmemizi sağlar. İsmi bir bahçıvanlık aracını çağrıştırsa da yaptığı iş oldukça bilgisayarcıdır: ağaçları bağlar, dalları keser ve yol bilgilerini verimli şekilde günceller.
Devamı...
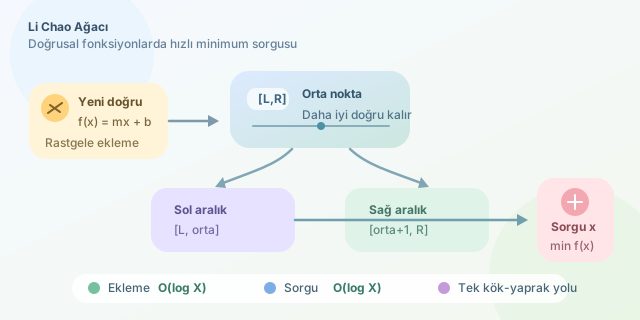
Elimizde sürekli yeni doğruların eklendiği ve belirli bir $x$ noktasında en küçük değeri veren doğrunun sorulduğu bir sistem düşünelim. Her sorguda bütün doğruları tek tek kontrol etmek kolaydır; fakat doğru ve sorgu sayısı yüz binlere ulaştığında bilgisayarımız küçük bir hesap makinesi gibi terlemeye başlar. Li Chao ağacı, bu doğrusal fonksiyon sorgularını logaritmik zamanda yanıtlayarak imdadımıza yetişir.
Devamı...
Bir programlama dilinde fonksiyon yazarken aslında 1930’larda ortaya atılmış matematiksel bir modelin izlerini takip ederiz. Parametreler, dönüş değerleri, anonim fonksiyonlar ve closure gibi modern araçların kökünde lambda calculus bulunur. Üstelik bu model, bilgisayarların henüz oda büyüklüğünde bile olmadığı bir dönemde geliştirilmiştir!
Devamı...
Birçok algoritmada kümeleri, listeleri veya sözlükleri tekrar tekrar birleştirmemiz gerekir. Bunu dikkatsizce yaptığımızda aynı elemanlar defalarca taşınır ve masum görünen kodumuz kağnı hızına düşer. Küçükten büyüğe birleştirme ya da İngilizce adıyla small-to-large merging, her adımda küçük koleksiyonu büyük koleksiyona ekleyerek toplam maliyeti kontrol altında tutan zarif bir tekniktir.
Devamı...
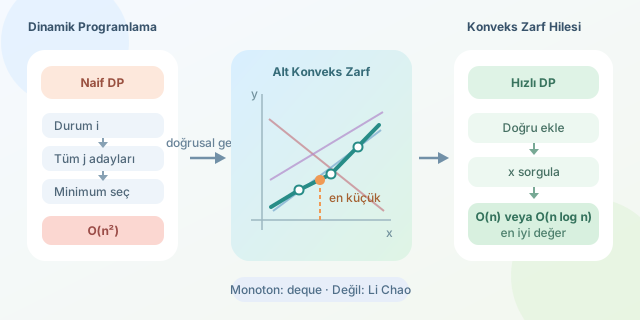
Dinamik programlama bazen doğru bağıntıyı bulduğumuz hâlde bizi $O(n^2)$ karmaşıklığıyla baş başa bırakır. Konveks Zarf Hilesi, İngilizce adıyla Convex Hull Trick (CHT), belirli biçimdeki geçişleri doğru parçaları olarak yorumlayarak bu maliyeti $O(n\log n)$, hatta uygun koşullarda $O(n)$ seviyesine indirebilir. Yani iç içe döngüleri geometrinin küçük ama etkili bir numarasıyla değiştiririz.
Devamı...
Bir programın çalışmaya başladıktan birkaç saniye sonra hızlanması ilk bakışta sihir gibi görünebilir. Oysa perde arkasında, kodu izleyen ve sık kullanılan bölümleri daha verimli makine koduna dönüştüren bir mekanizma vardır: JIT (Just-In-Time) derleme. Java, JavaScript ve .NET gibi platformlarda kullanılan bu yaklaşım, yorumlayıcının esnekliğiyle önceden derlemenin hızını birleştirir.
Devamı...
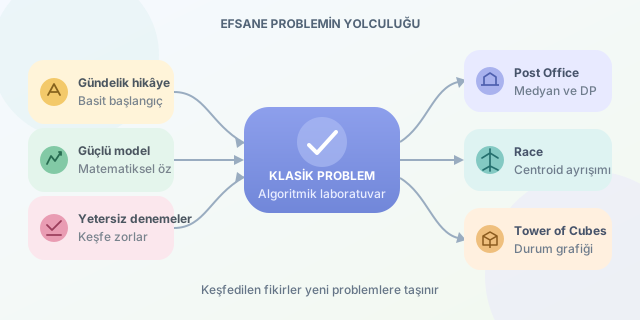
Bazı yarışma problemleri çözülüp unutulur; bazılarıysa yıllar sonra bile eğitim kamplarında, çevrim içi jürilerde ve algoritma sohbetlerinde karşımıza çıkar. IOI ile ICPC tarihinde klasikleşen soruların sırrı yalnızca zor olmaları değildir. Bu problemler, gündelik görünen bir hikâyenin altına güçlü bir matematiksel model saklar ve çözücüye belirli bir algoritmayı ezberletmek yerine onu keşfettirir.
Devamı...