İçindekiler
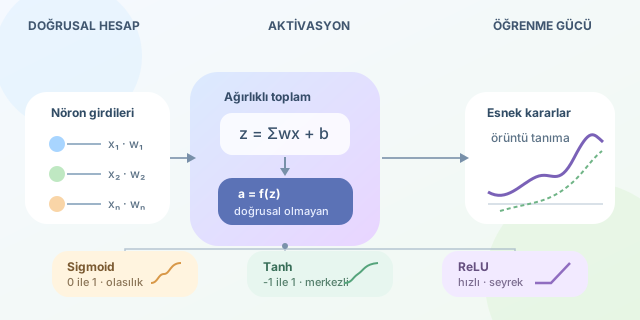
Yapay sinir ağları ilk bakışta katman katman matris çarpımı yapan hesap makineleri gibi görünür. Fakat bu yapı tek başına karmaşık karar sınırları öğrenemez: Ne kadar çok doğrusal katman eklenirse eklensin, sonuç hâlâ doğrusal bir dönüşümdür. Aktivasyon fonksiyonları tam bu noktada devreye girer; nöronların çıktısına kıvrım, eşik ve seçicilik katarak ağın görüntü tanıma, dil işleme veya tahmin gibi zor problemleri çözmesini sağlar. ``
Bir nöronun temel hesabı, girdilerin ağırlıklarla çarpılıp toplanmasıdır:
\[z = \sum_{i=1}^{n} w_i x_i + b\]Burada $x_i$ girdiyi, $w_i$ öğrenilen ağırlığı ve $b$ bias (sapma) değerini temsil eder. Aktivasyon uygulanmazsa katman çıktısı yalnızca $z$ olur. İki katman için $W_2(W_1x+b_1)+b_2$ ifadesi düzenlendiğinde yine tek bir $Wx+b$ doğrusal formuna dönüşür. Yani katman sayısı artar, fakat modelin ifade gücü beklenen ölçüde artmaz. Aktivasyon fonksiyonu $a=f(z)$ ise bu sadeleşmeyi bozar ve ağ doğrusal olmayan örüntüleri yakalayabilir.
Sigmoid: Olasılık Hissi Veren Klasik
Sigmoid fonksiyonu her gerçek sayıyı 0 ile 1 arasına sıkıştırır:
\[\sigma(z) = \frac{1}{1+e^{-z}}\]Büyük pozitif değerler 1’e, büyük negatif değerler 0’a yaklaşır. Bu nedenle ikili sınıflandırmanın son katmanında, bir örneğin pozitif sınıfa ait olma olasılığını temsil etmek için yaygındır. Ancak türevi $\sigma(z)(1-\sigma(z))$ olduğundan, uç bölgelerde türev çok küçülür. Geri yayılım sırasında gradyanlar katmanlar boyunca çarpıldığı için bu durum kaybolan gradyan sorununa yol açabilir.
Tanh: Merkezlenmiş Alternatif
Hiperbolik tanjant, sigmoidin -1 ile 1 arasında çalışan kuzenidir:
\[\tanh(z)=\frac{e^z-e^{-z}}{e^z+e^{-z}}\]Çıktısının sıfır merkezli olması, özellikle gizli katmanlardaki ağırlık güncellemelerini daha dengeli hâle getirebilir. Buna rağmen Tanh da doygunluğa ulaşır: $ \vert z \vert $ büyüdükçe türev azalır. Bu yüzden derin ağların her gizli katmanında varsayılan tercih olmaktan büyük ölçüde çıkmıştır.
| Fonksiyon | Çıktı aralığı | Güçlü yönü | Temel riski |
|---|---|---|---|
| Sigmoid | $(0, 1)$ | Olasılık yorumuna uygundur | Kaybolan gradyan, sıfır merkezli değildir |
| Tanh | $(-1, 1)$ | Sıfır merkezli çıktı | Doygunluk ve kaybolan gradyan |
| ReLU | $[0, \infty)$ | Hızlı ve seyrek aktivasyon | Ölü nöronlar |
ReLU: Basit Ama Etkili
ReLU (Rectified Linear Unit) aşağıdaki kadar yalındır:
\[\operatorname{ReLU}(z)=\max(0,z)\]Negatif girdileri sıfırlar, pozitif girdileri değiştirmeden geçirir. Pozitif bölgede türevin 1 olması gradyanın daha rahat akmasına yardım eder; hesaplaması da sigmoid ve Tanh’a göre ucuzdur. Bunun bedeli, sürekli negatif girdi alan nöronların çıktısının ve türevinin 0 kalabilmesidir. Bu olaya ölü ReLU denir.
Aşağıdaki NumPy örneği, üç fonksiyonun davranışını aynı girdi üzerinde görünür kılar:
import numpy as np

x = np.array([-3.0, -1.0, 0.0, 1.0, 3.0])

sigmoid = 1 / (1 + np.exp(-x))
tanh = np.tanh(x)
relu = np.maximum(0, x)

print("Sigmoid:", sigmoid)
print("Tanh:", tanh)
print("ReLU:", relu)
Bu kodda negatif 3 için ReLU doğrudan 0 üretirken, Sigmoid küçük ama sıfır olmayan bir değer verir; Tanh ise -1’e yaklaşır. Dolayısıyla seçim yalnızca matematiksel zevk değildir, problemin çıktısına bağlıdır. Gizli katmanlarda ReLU çoğu zaman güçlü başlangıç seçeneğidir; ikili sınıflandırma çıkışında Sigmoid, çok sınıflı sınıflandırmada ise genellikle Softmax kullanılır. Aktivasyonlar, ağın küçük ama kritik virajlarıdır: Onlar olmadan derinlik vardır, fakat gerçek öğrenme esnekliği yoktur.
Yorumlar