Bir fabrikanın sıcaklık sensörlerini düşünün: cihazlar her 10 saniyede bir ölçüm üretir, ancak Wi-Fi kopmaları, mobil ağ gecikmeleri ve cihaz tamponları nedeniyle kayıtlar Flink’e kronolojik sırayla ulaşmaz. İşleme zamanına güvenmek, örneğin 10:00:05’te üretilen ama 10:00:40’ta gelen kritik bir sıcaklık artışını yanlış pencereye koyabilir. Apache Flink’in event-time yaklaşımı, olayın sisteme geliş anını değil, olayın gerçekten gerçekleştiği anı merkezine alır.
``
Neden event-time?
Bir akış uygulamasında üç zaman kavramı vardır. IoT analitiğinde çoğunlukla hedefimiz, sensörün kaydı oluşturduğu zamana göre doğru hesap yapmaktır. Bu nedenle eventTime alanını güvenilir biçimde üretmek ve taşımak kritik önemdedir.
| Zaman türü | Tanım | IoT açısından sonuç |
|---|---|---|
| Event time | Olayın sensörde oluştuğu zaman | Doğru tarihsel analiz sağlar |
| Ingestion time | Kaynağın olayı Flink’e verdiği zaman | Kaynak gecikmesini kısmen yansıtır |
| Processing time | Operatörün olayı işlediği zaman | Düşük gecikmeli, ama sırasız veride hatalı olabilir |
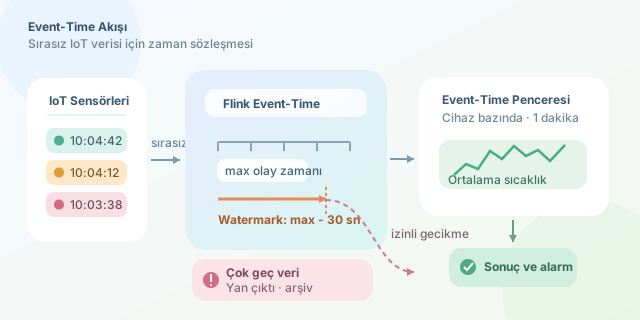
Örneğimizde her olay {deviceId, temperature, eventTime} alanlarını taşır. Beş dakikalık pencerede ortalama sıcaklık hesaplayalım. İdeal hedef şudur:
Burada $d$ cihazı, $w$ event-time penceresini, $T_i$ ise o pencereye ait ölçümleri temsil eder. Zorluk, hangi ölçümün pencereye hâlâ kabul edilebileceğini bilmektir.
Watermark: Akışın zaman saati
Watermark, Flink’in “bu zamandan daha eski olayların artık gelmesini beklemiyorum” ifadesidir. En yaygın strateji sınırsız sırasızlık varsayımıdır:
\[W = \max(E) - \Delta\]$\max(E)$ şimdiye kadar görülen en büyük event-time, $\Delta$ ise tolere edilen gecikmedir. Örneğin en yeni sensör olayı 10:05:30 ve gecikme payı 30 saniyeyse watermark 10:05:00 olur. 10:05:00’dan önce biten pencereler tetiklenebilir.
Aşağıdaki DataStream API örneği, Kafka’dan gelen IoT verisine 30 saniyelik sırasızlık toleransı ekler. Ardından cihaz bazında bir dakikalık pencereyle ortalama hesaplar:
WatermarkStrategy<SensorReading> strategy = WatermarkStrategy
    .<SensorReading>forBoundedOutOfOrderness(Duration.ofSeconds(30))
    .withTimestampAssigner((reading, timestamp) -> reading.eventTime());

DataStream<SensorReading> readings = env
    .fromSource(kafkaSource, WatermarkStrategy.noWatermarks(), "iot-kafka")
    .assignTimestampsAndWatermarks(strategy);

OutputTag<SensorReading> lateReadings = new OutputTag<>("late-readings");

SingleOutputStreamOperator<TemperatureAlert> alerts = readings
    .keyBy(SensorReading::deviceId)
    .window(TumblingEventTimeWindows.of(Time.minutes(1)))
    .allowedLateness(Time.minutes(2))
    .sideOutputLateData(lateReadings)
    .aggregate(new AverageTemperatureAggregator());

DataStream<SensorReading> tooLate = alerts.getSideOutput(lateReadings);
Bu kodda watermark pencereyi ilk kez kapatır; allowedLateness ise kapanmış pencereye iki dakika boyunca geç kayıtların güncelleme gönderebilmesine izin verir. Daha da geç gelenler ana sonucu sessizce bozmamalıdır: sideOutputLateData, onları ayrı bir akışa yollar. Bu akış S3’e arşivlenebilir, kalite panosunda izlenebilir veya düzeltme (backfill) sürecine aktarılabilir.
| Seçenek | Avantaj | Bedel |
|---|---|---|
| Küçük $\Delta$ | Sonuçlar hızlı oluşur | Geç veri kaybı artar |
| Büyük $\Delta$ | Daha doğru pencere sonuçları | Gecikme ve state büyür |
allowedLateness |
Geç veriye düzeltme şansı | Aynı pencere için güncelleme üretir |
| Side output | Kayıp veri görünür olur | Ek işleme hattı gerekir |
Operasyonel ipuçları
Watermark değerini tahminle seçmeyin. Önce cihaz bazında processingTime - eventTime dağılımını ölçün; örneğin olayların %99’u 25 saniye içinde geliyorsa 30 saniye makul bir başlangıçtır. Boşta kalan Kafka bölümleri watermark’ı geride tutabileceğinden withIdleness(...) kullanmak da önemlidir. Son olarak, geç veri politikasını iş ekibiyle netleştirin: sıcaklık alarmı için geç de olsa düzeltme mi yapılacak, yoksa yalnızca denetim kaydı mı tutulacak? Watermark teknik bir ayar değil, veri doğruluğu ile karar alma hızı arasındaki bilinçli sözleşmedir.
Yorumlar