İçindekiler
Bir cümledeki her kelime eşit derecede önemli değildir: “Banka nehir kenarında yeni bir şube açtı” ifadesinde banka kelimesinin anlamını çözmek için “nehir kenarında” bölümü kritik ipucudur. Modern dil modelleri bu tür bağlantıları, dikkat (attention) mekanizması sayesinde yakalar. Transformer mimarisi ise bu mekanizmayı merkeze alarak sıralı işlem zorunluluğunu azaltmış, büyük ölçekli dil modellerinin önünü açmıştır. ``
Neden Eski Yaklaşımlar Zorlanıyordu?
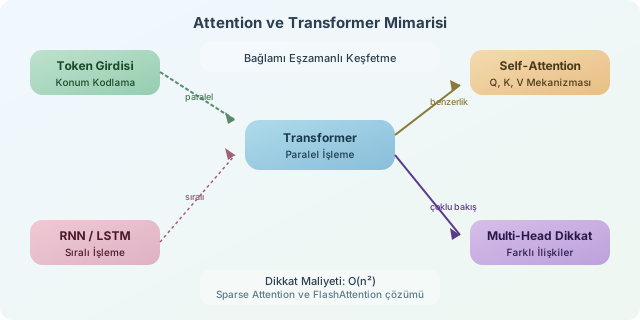
RNN ve LSTM gibi tekrarlayan sinir ağları metni soldan sağa, adım adım işler. Bu yaklaşım dilin sırasal doğasına uygundur; ancak uzun cümlelerde ilk kelimelerin etkisi zayıflayabilir. Ayrıca her zaman adımı bir öncekine bağımlı olduğundan GPU’larda paralel hesaplama verimi düşer. Transformer, tüm token’ları aynı anda değerlendirerek bu darboğazı büyük ölçüde aşar.
| Özellik | RNN / LSTM | Transformer |
|---|---|---|
| İşleme biçimi | Sıralı | Paralel |
| Uzak bağlam | Zorlaşabilir | Attention ile doğrudan erişim |
| Eğitim hızı | Görece düşük | Donanımda daha verimli |
| Konum bilgisi | Doğal olarak sıralıdır | Positional encoding gerekir |
Self-Attention Nasıl Çalışır?
Her token için model üç farklı temsil üretir: Query (Q), Key (K) ve Value (V). Bunu bir arama sistemi gibi düşünebilirsiniz: Query, “hangi bilgiye ihtiyacım var?” sorusudur; Key, her kelimenin etiketi; Value ise taşınacak içeriktir. Bir kelimenin diğerlerine ne kadar dikkat vereceği, Query ve Key benzerliğiyle hesaplanır.
Temel formül şöyledir:
\[Attention(Q, K, V) = softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]Buradaki $QK^T$ benzerlik puanlarını üretir. $\sqrt{d_k}$ ile bölme işlemi, boyut büyüdüğünde puanların aşırı uçlara gitmesini engeller. Sonrasında softmax, puanları olasılıksal ağırlıklara dönüştürür. Böylece “o” zamiri, cümlede hangi isme gönderme yapıyorsa onun temsilinden daha fazla bilgi alabilir.
Çok Kafalı Dikkat: Tek Bakış Açısı Yetmez
Bir cümlede aynı anda hem dilbilgisel ilişkiyi hem anlamsal yakınlığı hem de zamir referansını izlemek isteyebiliriz. Multi-head attention, Q, K ve V uzaylarını birden fazla küçük başlığa ayırır. Her başlık farklı bir ilişki türünü öğrenebilir; sonuçlar birleştirilerek daha zengin bir temsil elde edilir.
import torch
import torch.nn.functional as F

# x: [batch, token_sayisi, gizli_boyut]
def self_attention(x, Wq, Wk, Wv):
    Q, K, V = x @ Wq, x @ Wk, x @ Wv
    skorlar = (Q @ K.transpose(-2, -1)) / (K.size(-1) ** 0.5)
    agirliklar = F.softmax(skorlar, dim=-1)
    return agirliklar @ V
Bu sadeleştirilmiş örnekte skorlar, her token’ın diğer token’lara bakışını tutan bir matristir. softmax sonrasında her satırın toplamı 1 olur; son çarpım da ağırlıklı bağlam vektörlerini üretir.
Transformer Katmanının Diğer Parçaları
Attention tek başına tüm mimari değildir. Her Transformer katmanında genellikle attention sonrasında token bazlı bir ileri beslemeli ağ (FFN), residual bağlantılar ve layer normalization bulunur. Residual bağlantı, önceki temsili koruyarak derin ağların daha kararlı öğrenmesine yardım eder. Çünkü model, gerekirse tamamen yeni bilgi üretmek yerine mevcut temsile küçük bir düzeltme ekleyebilir.
Token’lar paralel işlendiği için doğal sıra bilgisi kaybolur. Bu nedenle modele konumsal kodlama eklenir. Sinüs-kosinüs tabanlı klasik yaklaşımda konum $pos$ ve boyut indeksi $i$ için örnek bir ifade şöyledir:
\[PE(pos, 2i) = \sin\left(\frac{pos}{10000^{2i/d}}\right)\]Sonuç: Bağlamı Ölçeklenebilir Biçimde Okumak
Encoder tabanlı BERT modelleri metni anlamaya, decoder tabanlı GPT ailesi ise sıradaki token’ı üretmeye odaklanır. Her ikisinin ortak motoru attention’dır. Bununla birlikte standart attention’ın maliyeti token sayısı $n$ için yaklaşık $O(n^2)$ olduğundan, çok uzun dokümanlar hâlâ pahalıdır. Sparse attention, FlashAttention ve uzun bağlam mimarileri tam da bu “dikkat pahalıdır” sorununu çözmeye çalışır. Kısacası Transformer, kelimeleri yalnızca sırayla okumaz; cümlenin tamamındaki ilişkiler ağını eşzamanlı biçimde keşfeder.
Yorumlar