İçindekiler
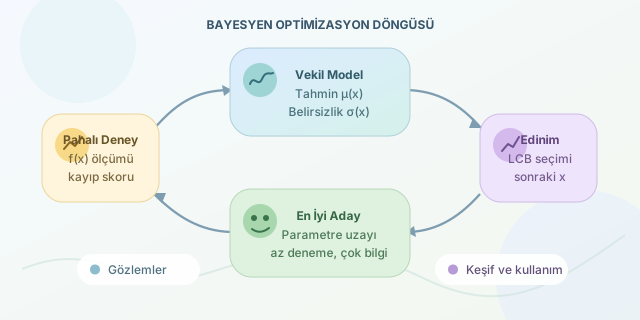
Bir modeli eğitmek saatler sürüyor, laboratuvar deneyi pahalı reaktifler tüketiyor ya da bir simülasyon tek çalıştırmada bulut faturasını kabartıyorsa klasik parametre taraması lükstür. Bayesian optimizasyon (BO), her denemeden öğrendiklerini kullanarak bir sonraki denemeyi stratejik biçimde seçer. Amaç, mümkün olan en az sayıda değerlendirmeyle en iyi parametre kombinasyonuna yaklaşmaktır.
``
Neden rastgele arama yetmez?
Elimizde optimize etmek istediğimiz, türevi bilinmeyen ve çalıştırılması pahalı bir amaç fonksiyonu olduğunu düşünelim:
\[x^* = \arg\min_{x \in \mathcal{X}} f(x)\]Buradaki $x$, örneğin öğrenme oranı, katman sayısı ve dropout değerinden oluşan parametre vektörüdür. $f(x)$ ise doğrulama hatası olabilir. Grid search tüm kombinasyonları dener; rastgele arama daha geniş alanları yoklar. Ancak ikisi de önceki deneylerin sonucundan doğrudan faydalanarak yeni nokta seçmez. BO’nun süper gücü tam olarak budur: Bilinmeyen fonksiyon için olasılıksal bir vekil model kurar ve belirsizliği de hesaba katar.
| Yaklaşım | Deneme seçimi | Pahalı değerlendirmelerde durum | Güçlü yanı |
|---|---|---|---|
| Grid Search | Önceden belirlenmiş ızgara | Genellikle verimsiz | Basit ve tekrarlanabilir |
| Random Search | Rastgele örnekleme | Orta düzey verim | Yüksek boyutta iyi başlangıç |
| Bayesian Optimizasyon | Önceki sonuçlara göre uyarlamalı | Çok avantajlı | Az denemeyle kaliteli sonuç |
Vekil model ve edinim fonksiyonu
BO iki ana parçadan oluşur. İlk parça, pahalı gerçek fonksiyonun yerine geçen surrogate (vekil) modeldir. En yaygın tercih Gaussian Process’tir (GP). GP, her $x$ noktası için yalnızca tahmin edilen ortalamayı $\mu(x)$ değil, tahmin belirsizliğini $\sigma(x)$ da üretir. Az gözlemlenmiş bölgelerde belirsizlik yüksektir; iyi görünen bölgelerde ise ortalama değer umut vericidir.
İkinci parça acquisition (edinim) fonksiyonudur. Bu fonksiyon, sıradaki denemenin nereye yapılacağını belirler. Örneğin minimizasyon için Lower Confidence Bound yaklaşımı şöyledir:
\[\mathrm{LCB}(x) = \mu(x) - \kappa\sigma(x)\]Burada $\kappa$ büyürse algoritma belirsiz, yani keşfedilmemiş alanlara daha çok yönelir. Küçülürse mevcut en iyi görünen bölgeyi sömürür. Bu ikilem, keşif (exploration) ile kullanımın (exploitation) dengelenmesidir.
| Kavram | Keşif ağırlıklı davranış | Kullanım ağırlıklı davranış |
|---|---|---|
| Seçilen bölge | Belirsizliği yüksek noktalar | Tahmini başarı yüksek noktalar |
| Risk | Zayıf aday denemek | Yerel optimumda kalmak |
| Ne zaman? | Başlangıçta veya veri azken | İyi bölge bulunduğunda |
Python ile pratik bir örnek
Aşağıdaki örnek, scikit-optimize kullanarak bir sınıflandırıcının hiperparametrelerini optimize eder. Fonksiyon her çağrıldığında model eğitilir; BO, sonuçlara göre yeni parametreleri kendisi önerir.
from skopt import gp_minimize
from skopt.space import Real, Integer
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_wine

X, y = load_wine(return_X_y=True)
space = [Integer(50, 400, name="n_estimators"),
         Integer(2, 20, name="max_depth"),
         Real(0.1, 1.0, name="max_features")]

def objective(params):
    n_estimators, max_depth, max_features = params
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        max_features=max_features,
        random_state=42
    )
    score = cross_val_score(model, X, y, cv=5).mean()
    return -score  # gp_minimize en küçük değeri arar

result = gp_minimize(objective, space, n_calls=30, random_state=42)
print("En iyi parametreler:", result.x)
print("En iyi doğruluk:", -result.fun)
Kodda kritik ayrıntı işaret dönüşümüdür: doğruluğu büyütmek istesek de gp_minimize kaybı küçülttüğü için -score döndürüyoruz. İlk birkaç deneme genellikle başlangıç verisi toplar; sonraki denemelerde GP tahminleri kararları yönlendirmeye başlar.
BO özellikle 10-50 civarı pahalı deneme bütçesinde parlaktır. Çok yüksek boyutlu uzaylarda, kategorik değişkenlerde veya paralel binlerce ucuz değerlendirmede etkisi azalabilir. Bu nedenle parametre aralığını alan bilgisiyle makul tutmak, gürültülü ölçümlerde tekrar çalıştırmak ve doğrulama kümesine aşırı uyumu izlemek gerekir. Doğru kurulduğunda Bayesian optimizasyon, körlemesine denemek yerine her başarısızlıktan bile bilgi çıkaran sabırlı bir deney yöneticisine dönüşür.
Yorumlar