İçindekiler
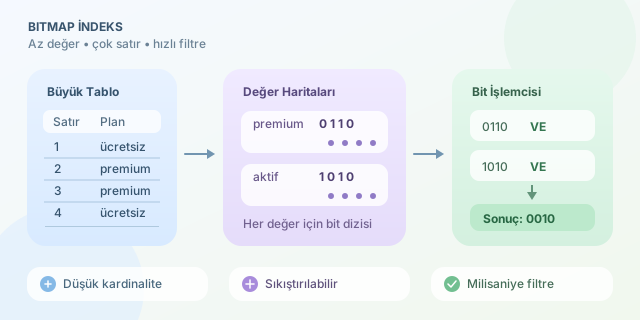
Milyarlarca satırlık bir tabloda belirli koşullara uyan kayıtları saniyeler yerine milisaniyeler içinde bulmak kulağa sihir gibi gelebilir. Bitmap index, bu numarayı her değer için bitlerden oluşan kompakt haritalar tutarak gerçekleştirir. Özellikle az sayıda farklı değer içeren sütunlarda, işlemcilerin son derece hızlı bit işlemlerinden yararlanır.
``
Bitmap index nedir?
Klasik bir B-tree indeksi, sütun değerlerini ve ilgili satırların adreslerini ağaç benzeri bir yapıda saklar. Bitmap index ise sütundaki her farklı değer için bir bit dizisi oluşturur. Dizideki her bit, tablodaki bir satırı temsil eder: Satır ilgili değere sahipse bit 1, aksi durumda 0 olur.
Örneğin dört satırlık bir kullanıcı tablomuz olsun:
| Satır | Plan | Aktif mi? |
|---|---|---|
| 1 | ücretsiz | evet |
| 2 | premium | hayır |
| 3 | premium | evet |
| 4 | ücretsiz | hayır |
Plan sütununun bitmap gösterimi şöyledir:
| Değer | Bitmap |
|---|---|
| ücretsiz | 1001 |
| premium | 0110 |
Aktif mi? sütununda evet değerinin haritası ise 1010 olur. Premium ve aktif kullanıcıları bulmak için iki bitmap üzerinde AND işlemi yapmak yeterlidir:
Sonuçtaki tek 1, koşula uyan ikinci satırı gösterir. Satırları tek tek karşılaştırmak yerine işlemci birkaç makine komutuyla onlarca veya yüzlerce biti birlikte değerlendirir.
Neden bu kadar hızlı?
Bir bitmap içindeki $N$ satırın ham depolama maliyeti yaklaşık olarak şöyledir:
\[Boyut = \frac{N}{8}\text{ bayt}\]Bir milyar satır için tek bitmap yaklaşık 125 MB tutar. Bu miktar ilk bakışta büyük görünse de tekrar eden bit dizileri RLE, Roaring Bitmap veya Word-Aligned Hybrid gibi yöntemlerle ciddi ölçüde sıkıştırılabilir. Üstelik sıkıştırılmış bitmapler çoğu zaman tamamen açılmadan işlenebilir.
Bitmaplerin asıl kozu birleşik filtrelerdir. Örneğin sorgu koşulu (premium AND aktif) OR kurumsal ise veritabanı bitmapleri doğrudan birleştirir:
sonuc = (premium_bitmap AND aktif_bitmap) OR kurumsal_bitmap
Bu yaklaşımın maliyeti kabaca bitmap uzunluğuyla ilişkilidir:
\[T(N) \approx O\left(\frac{N}{w}\right)\]Burada $w$, işlemcinin tek seferde işleyebildiği kelime genişliğidir; modern sistemlerde genellikle 64 bittir. SIMD komutları kullanıldığında aynı anda daha da fazla bit işlenebilir.
B-tree ile karşılaştırma
| Özellik | Bitmap index | B-tree index |
|---|---|---|
| İdeal veri | Düşük kardinalite | Yüksek kardinalite |
| Birleşik filtreler | Çok hızlı | Ek tarama gerektirebilir |
| Sık güncelleme | Genellikle maliyetli | Daha uygundur |
| Analitik sorgular | Mükemmel | Orta veya iyi |
| Tekil kayıt arama | Gereksiz olabilir | Çok başarılı |
Kardinalite, bir sütundaki farklı değer sayısıdır. Cinsiyet, üyelik tipi, ülke, durum veya ürün kategorisi gibi alanlar bitmap index için güçlü adaylardır. E-posta adresi ya da benzersiz kullanıcı kimliği gibi neredeyse her satırda değişen alanlarda ise ayrı bitmaplerin sayısı büyür ve avantaj azalır.
Küçük bir uygulama
Python tamsayıları bit dizisi gibi kullanılabilir. Aşağıdaki örnek iki filtreyi birleştirir:
premium = 0b0110
active = 0b1010

matched = premium & active

for row_index in range(4):
    mask = 1 << (3 - row_index)
    if matched & mask:
        print(f'Uyan satır: {row_index + 1}')
& operatörü bit düzeyinde AND uygular. mask değişkeni sırayla her satırın bitini kontrol eder. Gerçek veritabanları aynı fikri gelişmiş sıkıştırma, paralellik ve CPU optimizasyonlarıyla devasa ölçekte uygular.
Ne zaman kullanılmalı?
Bitmap index; veri ambarları, OLAP sistemleri, raporlama panelleri ve çok boyutlu filtreleme senaryolarında parlar. Buna karşılık binlerce eşzamanlı işlemin aynı satırları sürekli değiştirdiği OLTP sistemlerinde bitmaplerin güncellenmesi kilitlenme ve yazma maliyeti doğurabilir.
Kısacası bitmap index, her probleme uygun evrensel bir çekiç değildir. Ancak düşük kardinaliteli sütunlar, çoğunlukla okunan veriler ve karmaşık filtreler bir araya geldiğinde küçücük bitler, devasa veri kümelerine karşı şaşırtıcı derecede güçlü bir silaha dönüşür.
Yorumlar