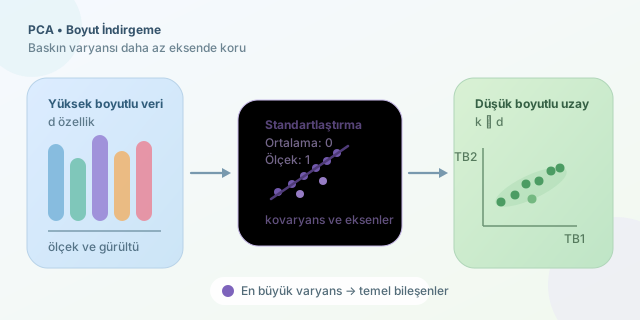
Yüksek boyutlu veriler ilk bakışta zengin görünür: her sütun yeni bir özellik, her özellik yeni bir ipucu demektir. Ancak onlarca hatta binlerce özellik, hesaplama maliyetini artırır; gürültüyü büyütür ve modellerin genelleme kabiliyetini zorlayabilir. Boyut indirgeme, bilgiyi rastgele silmek yerine verideki baskın örüntüleri daha az sayıda eksende toplamayı hedefler. Temel Bileşenler Analizi (PCA), bu işin en klasik ve güçlü araçlarından biridir. ``
PCA’nın arkasındaki ana fikir oldukça sezgiseldir: Verinin en fazla değiştiği yönleri bulmak. İki özellikli bir veri kümesindeki noktalar çapraz bir bulut oluşturuyorsa, hem x hem de y eksenini ayrı ayrı takip etmek yerine bulutun uzandığı ana doğrultuyu kullanabiliriz. Bu doğrultu birinci temel bileşen olur. Ona dik olan ve kalan değişimi en iyi açıklayan doğrultu ise ikinci temel bileşendir.
Matematiksel olarak veri matrisi $X \in \mathbb{R}^{n \times d}$ olsun. PCA uygulamadan önce her sütun ortalanır; yani özellik ortalaması çıkarılır. Ardından kovaryans matrisi hesaplanır:
\[\Sigma = \frac{1}{n-1}X^T X\]Bu matrisin özvektörleri yeni eksenleri, özdeğerleri ise bu eksenlerde açıklanan varyans miktarını verir. En büyük özdeğere karşılık gelen özvektör ilk temel bileşendir. İlk $k$ bileşeni seçtiğimizde dönüşüm şu şekilde yazılır:
\[Z = XW_k\]Burada $W_k$, seçilen $k$ özvektörü; $Z$ ise daha düşük boyutlu temsilimizdir. Amaç, $k \ll d$ iken mümkün olduğunca çok varyansı korumaktır.
| Kavram | Orijinal veri uzayı | PCA sonrası uzay |
|---|---|---|
| Özellik sayısı | $d$ | $k$ |
| Eksenlerin anlamı | Orijinal ölçümler | Özelliklerin doğrusal birleşimleri |
| Korelasyon | Yüksek olabilir | Bileşenler birbirine diktir |
| Yorumlanabilirlik | Genellikle yüksek | Bazen daha düşüktür |
| Hesaplama maliyeti | Büyük olabilir | Çoğu modelde azalır |
Önemli bir ayrıntı: PCA ölçeğe duyarlıdır. gelir değerleri binlerle, yaş değerleri onlar seviyesindeyse gelir sütunu varyansı tek başına domine edebilir. Bu nedenle çoğu senaryoda standartlaştırma yapılır. Her özellik için $x’ = (x-\mu)/\sigma$ dönüşümü, sütunları karşılaştırılabilir hale getirir.
Aşağıdaki Python örneği, Iris veri setini dört boyuttan iki boyuta indirir. Kod ayrıca iki bileşenin ne kadar bilgiyi, yani varyansı, koruduğunu gösterir.
from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

iris = load_iris()
X = iris.data

# PCA öncesinde farklı ölçekleri dengeliyoruz.
X_scaled = StandardScaler().fit_transform(X)

pca = PCA(n_components=2)
X_reduced = pca.fit_transform(X_scaled)

print("Yeni şekil:", X_reduced.shape)
print("Açıklanan varyans:", pca.explained_variance_ratio_)
print("Toplam korunan bilgi:", pca.explained_variance_ratio_.sum())
explained_variance_ratio_ çıktısı, her bileşenin taşıdığı varyans payını verir. Örneğin toplam değer $0.95$ ise, dört özelliğin değişkenliğinin yaklaşık %95’i iki eksende korunmuş demektir. Bu, görselleştirme için harika bir sonuçtur; fakat her zaman tahmin performansının da aynı oranda korunacağı anlamına gelmez.
Bileşen sayısını seçerken sabit bir sihirli sayı yoktur. Yaygın yaklaşım, kümülatif açıklanan varyansı incelemektir. %90 veya %95 eşiği sık kullanılır; ancak sınıflandırma ya da regresyon hedefi varsa farklı $k$ değerlerini çapraz doğrulama ile denemek daha sağlıklıdır.
| PCA ne zaman iyi bir seçimdir? | PCA ne zaman dikkat ister? |
|---|---|
| Özellikler güçlü biçimde koreleyse | İlişkiler doğrusal değilse |
| Görselleştirme gerekiyorsa | Özellik isimleri kritikse |
| Gürültü azaltılması hedefleniyorsa | Aykırı değerler yoğunsa |
| Model eğitimi yavaşsa | Sınıf ayrımı düşük varyanslı yöndeyse |
PCA bir sihirbaz değil, akıllı bir projeksiyon aracıdır. Veriyi daha küçük bir bavula yerleştirir; fakat hangi eşyaların gerçekten gerekli olduğuna varyans üzerinden karar verir. Bu yüzden sonuçları model metriği, açıklanan varyans ve alan bilgisiyle birlikte değerlendirmek en doğru yaklaşımdır.
Yorumlar