İçindekiler
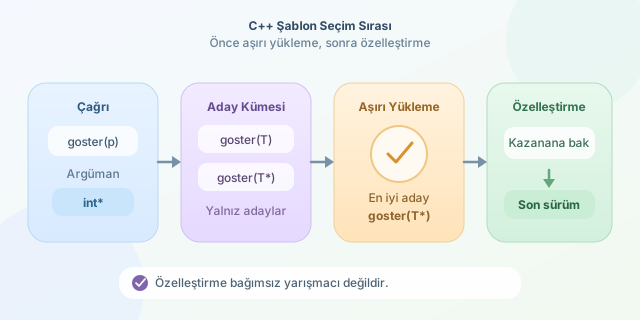
C++ şablonlarında özelleştirme ve aşırı yükleme aynı hedefe gidiyormuş gibi görünür: belirli türlerde farklı davranmak. Fakat derleyicinin gözünde bunlar iki ayrı mekanizmadır. Overloading adaylar arasındaki yarışı belirlerken specialization, yarışı kazanan şablonun özel bir sürümünün bulunup bulunmadığına bakar. Küçük görünen bu sıra farkı, şaşırtıcı sonuçların kaynağıdır.
``
İki mekanizmanın temel anlamı
Bir fonksiyon şablonunu aşırı yüklediğimizde derleyicinin aday listesine yeni bir fonksiyon şablonu ekleriz. Açık özelleştirme ise yeni ve bağımsız bir aday oluşturmaz; mevcut birincil şablonun belirli argümanlar için alternatif uygulamasını tanımlar.
#include <iostream>

template<typename T>
void goster(T) {
    std::cout << "Genel sürüm\n";
}

template<>
void goster<int>(int) {
    std::cout << "int özelleştirmesi\n";
}

template<typename T>
void goster(T*) {
    std::cout << "İşaretçi overload'u\n";
}
Burada üç bildirim varmış gibi görünse de overload çözümlemesinde yalnızca goster(T) ve goster(T*) yarışır. goster<int> ise ilk şablona bağlı bir açık özelleştirmedir.
| Özellik | Overloading | Specialization |
|---|---|---|
| Yeni aday oluşturur mu? | Evet | Hayır |
| Fonksiyonlarda kısmi biçimi var mı? | Overload ile benzetilebilir | Hayır |
| Seçim zamanı | Overload çözümlemesi sırasında | Birincil şablon seçildikten sonra |
| Kapsam | Fonksiyon ve normal fonksiyonlar | Birincil şablona bağlı |
| Temel amaç | Farklı parametre biçimleri | Belirli argüman için özel uygulama |
Derleyicinin seçim sırası
Basitleştirilmiş süreç şöyledir:
- Görünür fonksiyonlar ve fonksiyon şablonları aday kümeye alınır.
- Şablon argüman çıkarımı yapılır.
- Dönüşüm kalitesi ve şablonların kısmi sıralaması değerlendirilir.
- En iyi overload seçilir.
- Kazanan bir fonksiyon şablonuysa ona ait açık özelleştirme aranır.
Bunu kabaca
\[\text{çağrılacak fonksiyon} = \operatorname{specialization}(\operatorname{bestOverload}(C))\]şeklinde düşünebiliriz. Buradaki $C$, uygun adaylar kümesidir. İşlemlerin sırası ters değildir; specialization önce yarışıp overload’u yenemez.
Klasik işaretçi sürprizi
int* p = nullptr;
goster(p);
İlk bakışta T = int* olduğundan genel şablonun int* özelleştirmesinin aranacağı düşünülebilir. Ancak goster(T*), int* argümanı için goster(T) şablonundan daha özeldir. Dolayısıyla pointer overload’u yarışı kazanır. Derleyici artık yalnızca bu kazanan şablona bağlı bir explicit specialization olup olmadığına bakar; diğer birincil şablonun özelleştirmesine geri dönmez.
Bu nedenle bir specialization’ın hangi birincil şablona bağlı olduğu kritik önemdedir. Bildirim sırası ve specialization bildiriminin çağrıdan önce görünür olması da ayrı derleme birimlerinde ciddi farklar yaratabilir. Açık özelleştirme, örtük örneklemeye yol açan ilk kullanımdan önce bildirilmelidir.
Neden fonksiyon şablonları kısmen özelleştirilemez?
Sınıf şablonlarında kısmi özelleştirme geçerlidir:
template<typename T>
struct Bilgi;

template<typename T>
struct Bilgi<T*> {
    static constexpr bool pointer = true;
};
Fakat aşağıdaki fonksiyon biçimi geçersizdir:
template<typename T>
void isle<T*>(T*); // Geçersiz kısmi specialization
Fonksiyonlarda aynı niyet overload ile ifade edilir:
template<typename T>
void isle(T*) {
    // Türetilen her işaretçi türü için ortak davranış
}
Bunun önemli nedeni, fonksiyonlarda zaten overload çözümlemesi bulunmasıdır. Kısmi specialization da eklenseydi iki ayrı sıralama sistemi birbiriyle çakışabilirdi.
Pratik tercih rehberi
Bir tür ailesini yakalamak istiyorsanız overload kullanın. Yalnızca tek ve kesin bir şablon argümanı kombinasyonunda davranışı değiştirecekseniz explicit specialization düşünülebilir. Bununla birlikte fonksiyonlarda overload çoğu zaman daha okunabilir ve öngörülebilirdir.
Modern C++ kodunda if constexpr, kavramlar ve requires ifadeleri de güçlü alternatiflerdir. Özellikle kısıtlı overload’lar, niyeti doğrudan tür sistemi üzerinden anlatır. Altın kural şudur: specialization’ı bağımsız yarışmacı sanmayın; o, ancak bağlı olduğu şablon yarışı kazandığında sahneye çıkan yedek oyuncudur.
Yorumlar