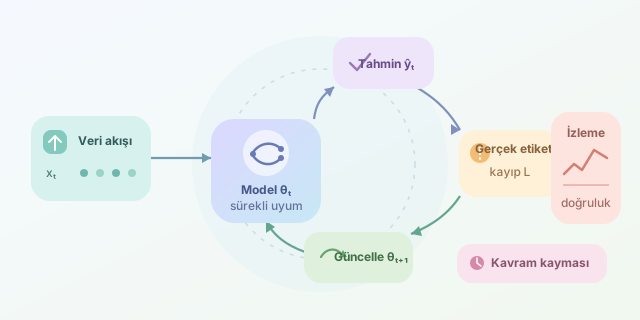
Bir makine öğrenmesi modelini bir kez eğitip sonsuza dek görev başında bırakmak, dünün hava durumuyla bugün şemsiye seçmeye benzer. Gerçek dünyadaki veriler; kullanıcı tercihleri, dolandırıcılık yöntemleri, sensör ölçümleri ve piyasa davranışlarıyla birlikte sürekli değişir. Çevrimiçi öğrenme (online learning), modelin tüm geçmiş veriyi yeniden işlemeye ihtiyaç duymadan yeni gözlemler geldikçe kendini küçük adımlarla güncellemesini sağlar. `` Klasik toplu öğrenmede (batch learning) veri kümesi baştan sona hazırlanır, model eğitilir ve üretime alınır. Online öğrenmede ise veri akışı ${(x_t, y_t)}_{t=1}^{\infty}$ şeklindedir. Model, $t$ anında $x_t$ girdisini görür, tahmin üretir, gerçek etiketi aldığında hatasını hesaplar ve parametrelerini günceller. Bu döngü özellikle milyonlarca kaydın aktığı veya verinin hızla bayatladığı sistemlerde güçlüdür.
Temel güncelleme fikri gradyan inişine dayanır. Kayıp fonksiyonu $L(\theta_t; x_t, y_t)$ ise parametreler şu şekilde değişir:
\[\theta_{t+1} = \theta_t - \eta_t \nabla_\theta L(\theta_t; x_t, y_t)\]Burada $\eta_t$ öğrenme oranıdır. Çok büyük seçilirse model yeni veriye aşırı tepki verir; çok küçük seçilirse değişen dünyaya yetişemez. Dolayısıyla online öğrenmenin asıl sihri yalnızca güncelleme yapmak değil, ne kadar hızlı unutacağını yönetmektir.
| Özellik | Toplu Öğrenme | Çevrimiçi Öğrenme |
|---|---|---|
| Veri işleme | Tüm veri bir arada | Kayıt veya küçük paketler halinde |
| Güncelleme sıklığı | Periyodik yeniden eğitim | Her gözlemden sonra veya mini-batch ile |
| Bellek ihtiyacı | Yüksek olabilir | Genellikle daha düşüktür |
| Değişime tepki | Gecikmeli | Hızlı |
| Risk | Eski model kullanımı | Gürültüye aşırı uyum |
Performansı incelerken tek bir sabit test doğruluğu yeterli değildir. Akan veride doğruluk, F1 skoru, log-loss ve gecikme gibi metrikleri zaman pencereleri üzerinde izlemek gerekir. Örneğin son $w$ gözlemdeki hareketli doğruluk şöyle tanımlanabilir:
\[Accuracy_w = \frac{1}{w}\sum_{i=t-w+1}^{t} \mathbb{1}(\hat{y}_i = y_i)\]Bu yaklaşım, modelin geçmişteki parlak günlerini değil, şu anki kondisyonunu gösterir. Ani performans düşüşleri kavram kaymasına (concept drift) işaret edebilir. Kavram kayması, örneğin sahte işlem yapanların davranış biçimini değiştirmesiyle, giriş dağılımının veya hedef ile girdiler arasındaki ilişkinin değişmesidir.
Python ekosisteminde river kütüphanesi, veri akışı senaryoları için pratik araçlar sunar. Aşağıdaki örnek, lojistik regresyon modelini her kayıt sonrasında eğitirken hareketli doğruluğu ölçer:
from river import compose, linear_model, metrics, preprocessing

model = compose.Pipeline(
    preprocessing.StandardScaler(),
    linear_model.LogisticRegression()
)
metric = metrics.Rolling(metrics.Accuracy(), window_size=200)

for features, label in veri_akisi:
    prediction = model.predict_one(features)

    if prediction is not None:
        metric.update(label, prediction)

    model.learn_one(features, label)
    print(f"Son 200 kayıtta doğruluk: {metric.get():.3f}")
Kodda predict_one, modelin güncellenmeden önceki dürüst tahminini üretir. Ardından learn_one, gerçek etiketi kullanarak modeli yeni örneğe göre ayarlar. Bu sıralama önemlidir; önce öğrenip sonra tahmin yapmak, sınavın cevap anahtarını önceden görmek olurdu.
| İzleme sinyali | Olası anlamı | Önerilen aksiyon |
|---|---|---|
| Doğrulukta ani düşüş | Kavram kayması | Öğrenme oranını veya pencereyi gözden geçir |
| Doğrulukta dalgalanma | Gürültü ya da az veri | Mini-batch ve yumuşatma kullan |
| Gecikme artışı | Model/altyapı yükü | Daha hafif model veya kuyruklama uygula |
| Sınıf dağılımı değişimi | Dengesizlik kayması | Ağırlıklandırma ve eşik ayarı yap |
Başarılı bir online learning sistemi, modeli sürekli eğitmekten ibaret değildir. Veri kalitesi kontrolleri, gecikmeli etiketler, geri alma stratejileri ve metrik alarmları da tasarımın parçasıdır. Böylece model, akan verinin içinde panikleyen bir öğrenci değil; değişimi fark eden, ölçen ve kontrollü biçimde uyum sağlayan bir ekip arkadaşı haline gelir.
Yorumlar