İçindekiler
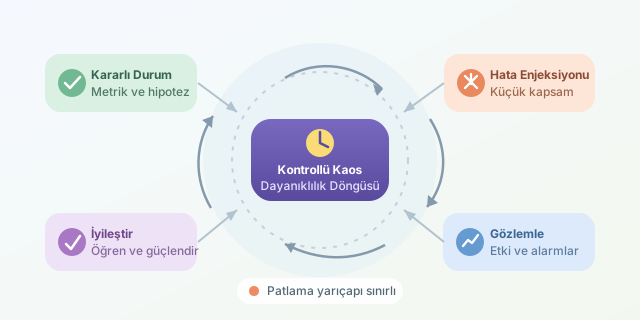
Bir sunucuyu üretim ortamında bilerek kapatmak ilk bakışta fişi çekilmiş bir kariyer planı gibi görünebilir. Oysa Chaos Engineering, sistemleri rastgele bozmak değil; beklenmeyen arızalar müşterileri bulmadan önce sistemin davranışını kontrollü deneylerle gözlemlemektir. Netflix’in geliştirdiği Chaos Monkey bu yaklaşımın en ünlü örneğidir: Çalışan sunucuları devre dışı bırakarak mimarinin gerçekten dayanıklı olup olmadığını sınar. ``
Kaos mühendisliği nedir?
Dağıtık sistemlerde arıza bir istisna değil, kaçınılmaz bir olaydır. Diskler bozulur, ağ paketleri kaybolur, servisler yavaşlar ve veri merkezleri erişilemez hâle gelir. Chaos Engineering, bu olayları kontrollü biçimde oluşturarak sistemin teknik ve operasyonel dayanıklılığını ölçen deneysel bir disiplindir.
Temel fikir bilimsel yönteme dayanır:
- Sistemin normal davranışı tanımlanır.
- Ölçülebilir bir hipotez kurulur.
- Sınırlı kapsamda hata enjekte edilir.
- Metrikler ve kullanıcı etkisi gözlemlenir.
- Bulgularla sistem iyileştirilir.
Örneğin hipotezimiz şu olabilir: “Ödeme servisinin bir örneği kapanırsa başarı oranı %99,9’un altına düşmez.” Başarı oranını matematiksel olarak şöyle ifade edebiliriz:
\[R = \frac{N_{başarılı}}{N_{toplam}} \times 100\]Deney sırasında $R < 99.9$ olursa hipotez çürütülür. Bu bir başarısızlık değil, gerçek bir kesintiden önce yakalanmış değerli bir mimari kusurdur.
Kaos testi ile klasik test arasındaki fark
| Özellik | Klasik test | Kaos deneyi |
|---|---|---|
| Ana amaç | Beklenen çıktıyı doğrulamak | Bilinmeyen zayıflıkları keşfetmek |
| Ortam | Genellikle test veya staging | Olgunluk düzeyine göre üretim |
| Senaryo | Önceden belirlenmiş girdi | Gerçekçi altyapı arızası |
| Sonuç | Başarılı veya başarısız | Gözlem, öğrenme ve iyileştirme |
| Örnek | API yanıtını doğrulamak | API sunucusunu aniden kapatmak |
Kontrollü yıkımın temel kuralları
Önce kararlı durumu tanımlayın. Gecikme, hata oranı, trafik ve doygunluk gibi göstergeler bilinmeden deney yapılamaz. “Sistem ayakta mı?” yerine “Kullanıcı ödeme yapabiliyor mu?” sorusu sorulmalıdır.
Küçük başlayın. İlk deney tüm veri merkezini kapatmak olmamalıdır. Tek bir konteyner, düşük trafikli servis veya çalışanların kullandığı dahili sistem daha güvenli bir başlangıçtır.
Patlama yarıçapını sınırlayın. Deneyin etkileyebileceği kullanıcı, sunucu ve süre önceden belirlenmelidir. Kritik eşik aşılırsa otomatik durdurma mekanizması devreye girmelidir.
Gözlemlenebilirlik kurun. Merkezi günlükler, dağıtık izleme, metrikler ve alarmlar hazır değilse kaos yalnızca karanlıkta eşya kırmaktır.
Ekibi haberdar edin. İlk deneyler gizlice yapılmamalıdır. SRE, geliştirici, güvenlik ve müşteri destek ekipleri deney planını ve geri dönüş prosedürünü bilmelidir.
Basit bir gecikme deneyi
Linux üzerindeki tc aracı, ağ trafiğine gecikme eklemek için kullanılabilir:
# eth0 üzerinden çıkan paketlere 200 ms gecikme ekler
sudo tc qdisc add dev eth0 root netem delay 200ms 50ms

# Deney bittiğinde kuralı kaldırır
sudo tc qdisc del dev eth0 root netem
Buradaki 200ms temel gecikme, 50ms ise değişkenliktir. Böylece servis keşfi, zaman aşımı, yeniden deneme ve circuit breaker mekanizmalarının gerçekçi bir yavaşlık altında davranışı görülebilir. Komut üretimde yalnızca kapsamı belirlenmiş makinelerde ve geri alma adımı doğrulandıktan sonra çalıştırılmalıdır.
Chaos Monkey tek başına yeterli mi?
Chaos Monkey yalnızca örnekleri kapatır; güvenilirlik ise yedeklilik, otomatik ölçeklendirme, doğru zaman aşımı, idempotent işlemler ve etkili olay müdahalesinin birleşimidir. Ayrıca yeniden deneme sayısı kontrolsüz bırakılırsa küçük bir kesinti “retry storm” oluşturarak sistemi tamamen boğabilir.
Başarılı kaos mühendisliği en büyük patlamayı üretmez; en düşük kullanıcı etkisiyle en değerli bilgiyi üretir. Amaç sistemi kırmak değil, sistem zaten kırıldığında ekibin hazırlıksız yakalanmasını önlemektir.
Yorumlar