İçindekiler
Bir fotoğrafı insan gözüyle tanımak birkaç saniye sürer; fakat bilgisayar için bu fotoğraf başlangıçta yalnızca devasa bir sayı tablosudur. Evrişimli Sinir Ağları ya da CNN’ler, bu sayıları anlamlı görsel örüntülere dönüştürmek için tasarlanmış derin öğrenme mimarileridir. Kedi kulağı, trafik levhası, tümör dokusu veya videodaki hareket gibi ayrıntıları; piksellerin birbirine komşu olma ilişkisini koruyarak öğrenirler. ``
Görüntü neden sıradan bir vektör değildir?
Renkli bir görüntü genellikle $H \times W \times 3$ boyutlu bir tensördür: yükseklik, genişlik ve RGB renk kanalları. Görüntüyü klasik bir yapay sinir ağına vermek için tek boyutlu vektöre çevirmek teorik olarak mümkündür. Ancak bu yaklaşımda yan yana duran piksellerin komşuluk bilgisi kaybolur. Ayrıca parametre sayısı hızla kontrolden çıkar.
CNN’nin temel fikri basittir: Küçük bir filtre, görüntü üzerinde gezdirilir ve belirli bir örüntüyü arar. İlk katmanlar kenarları ve renk geçişlerini yakalarken, derin katmanlar göz, tekerlek, yüz veya nesne parçaları gibi daha karmaşık yapıları temsil edebilir. Bu hiyerarşik yapı, görsel algının dijital versiyonu gibidir.
| Yaklaşım | Piksel komşuluğu | Parametre maliyeti | Görsel örüntü başarısı |
|---|---|---|---|
| Tam bağlantılı ağ | Büyük ölçüde kaybolur | Çok yüksek | Sınırlı |
| CNN | Korunur | Paylaşılan filtrelerle düşük | Yüksek |
| Vision Transformer | Parçalara ayırarak işler | Genellikle yüksek | Büyük veriyle güçlü |
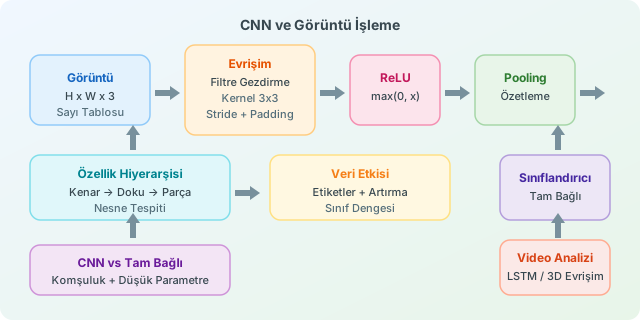
Evrişim işlemi: Filtrenin dedektifliği
Bir evrişim filtresi, örneğin $3 \times 3$ boyutunda küçük bir ağırlık matrisi olabilir. Filtre görüntüdeki her pencereyle eleman bazında çarpılır ve sonuçlar toplanır. Tek kanallı basit bir ifade şöyledir:
\[Y(i,j) = \sum_m \sum_n X(i+m, j+n)K(m,n) + b\]Burada $X$ giriş görüntüsü, $K$ filtre çekirdeği, $b$ bias ve $Y$ üretilen öznitelik haritasıdır. Eğitim sırasında ağ, hangi $K$ değerlerinin kenar, doku veya başka bir anlamlı sinyal yakaladığını kendisi öğrenir. Yani filtreler elle yazılan kural değil, veriden türetilen mini uzmanlardır.
stride filtrenin kaç piksel atlayarak ilerleyeceğini, padding ise kenarlara eklenen dolgu miktarını belirler. Çıkış boyutu genel olarak şu formülle hesaplanır:
| Kavram | Görevi | Pratik etkisi |
|---|---|---|
| Kernel | Yerel örüntü arar | Kenar, doku ve şekil tespiti |
| Stride | Filtrenin adımını belirler | Büyük değer, daha küçük çıktı |
| Padding | Kenarları korur | Uzamsal boyut kaybını azaltır |
| Pooling | Özellikleri özetler | Hesaplama maliyetini düşürür |
Katmanlar birlikte nasıl karar verir?
Tipik bir CNN akışı Conv -> ReLU -> Pooling bloklarının tekrarından oluşur. ReLU, $f(x)=\max(0,x)$ ile negatif değerleri sıfırlayarak doğrusal olmayan öğrenmeyi mümkün kılar. Pooling katmanı ise bir bölgedeki en güçlü yanıtı seçebilir. Örneğin max pooling, bir kenarın tam olarak birkaç piksel sağa kaymasına karşı modeli daha dayanıklı yapar.
Aşağıdaki PyTorch örneği, görüntü sınıflandırması için orta düzeyde bir CNN iskeleti kurar:
import torch.nn as nn

class MiniCNN(nn.Module):
    def __init__(self, class_count=10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1))
        )
        self.classifier = nn.Linear(64, class_count)

    def forward(self, x):
        x = self.features(x)
        return self.classifier(x.flatten(1))
Bu model, RGB görüntüden 32 sonra 64 özellik kanalı çıkarır; AdaptiveAvgPool2d farklı giriş boyutlarıyla çalışmayı kolaylaştırır. Video analizinde aynı CNN her kareye uygulanabilir; ardından zaman bilgisini öğrenmek için LSTM, 3B evrişim veya Transformer eklenebilir.
CNN projelerinde başarının gizli kahramanı veridir: doğru etiketler, veri artırma, sınıf dengesi ve eğitim-test ayrımı çoğu zaman katman sayısından daha önemlidir. Modeliniz kediyi tanıyor ama pencereyi kedi sanıyorsa, suçlu her zaman mimari değildir; veri seti de biraz dedikodu yapıyor olabilir.
Yorumlar