İçindekiler
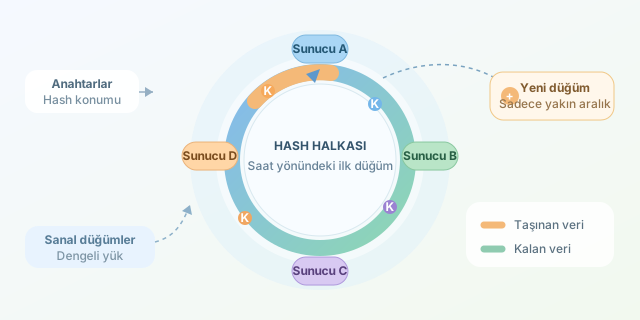
Dağıtık sistemlerde veriyi sunuculara paylaştırmak ilk bakışta kolay görünür: bir anahtarın hash değerini alır, sunucu sayısına göre modunu hesaplar ve hedefi buluruz. Fakat yeni bir sunucu eklediğinizde ya da arızalı bir makineyi kümeden çıkardığınızda bu sade yaklaşım, neredeyse bütün verilerin farklı yerlere taşınmasına yol açabilir. Consistent Hashing, tam bu taşınma fırtınasını küçültmek için tasarlanmış akıllı bir dağıtım tekniğidir. ``
Klasik mod alma neden sorun çıkarır?
Geleneksel yöntemde hedef sunucu genellikle şu formülle belirlenir:
\[server = hash(key) \bmod N\]Burada $N$, aktif sunucu sayısıdır. Örneğin user:42 anahtarının hash değeri 104 olsun. Dört sunuculu bir kümede hedef $104 \bmod 4 = 0$ iken, beşinci sunucu geldiğinde sonuç $104 \bmod 5 = 4$ olur. Dahası, yalnızca bu anahtar değil, mod sonucu değişen çok büyük bir anahtar kümesi yeni sunuculara kayar.
| Yaklaşım | Sunucu eklenince etkilenen veri | Uygulama zorluğu | Tipik kullanım |
|---|---|---|---|
hash(key) % N |
Yaklaşık tüm anahtarlar | Düşük | Sabit boyutlu kümeler |
| Consistent Hashing | Ortalama $1/N$ oranı | Orta | Cache, shard, CDN |
Bu durum özellikle Redis/Memcached tabanlı önbelleklerde pahalıdır. Cache anahtarları başka düğümlere yöneldiği için cache miss oranı aniden yükselir; sistem, veritabanına gereksiz bir istek yağmuru gönderebilir. Buna bazen sevimli olmayan adıyla cache stampede denir.
Hash halkası fikri
Consistent Hashing, hash uzayını doğrusal bir dizi yerine dairesel bir halka gibi düşünür. Örneğin 32 bitlik bir hash fonksiyonunda halka $[0, 2^{32}-1]$ aralığındadır. Hem sunucular hem de veri anahtarları bu halkada bir konuma hash’lenir.
Bir anahtarın sahibi, halkada onun saat yönündeki ilk sunucusudur. Anahtarın önünde hiç sunucu yoksa halka sarar ve en küçük konumlu sunucu seçilir. Yeni bir sunucu eklendiğinde yalnızca kendisinden önceki sunucunun sahip olduğu aralıktaki anahtarları devralır. Dolayısıyla sunucu sayısı $N$ ise beklenen taşınma oranı yaklaşık olarak şöyledir:
\[P(taşınma) \approx \frac{1}{N}\]Bir sunucu ayrıldığında da yalnızca onun aralığındaki veriler bir sonraki düğüme gider. Kümeyi büyütmek artık ev taşımak değil, komşudan küçük bir kitap rafı devralmak gibidir.
Basit bir yerleştirme örneği
Aşağıdaki Python örneği, halkayı sıralı bir listeyle temsil eder. Gerçek dünyada daha hızlı arama için dengeli ağaçlar veya ikili arama kullanılır.
import hashlib
import bisect

MAX_HASH = 2 ** 32

def h(value: str) -> int:
    digest = hashlib.md5(value.encode()).hexdigest()
    return int(digest, 16) % MAX_HASH

nodes = sorted((h(name), name) for name in ["node-a", "node-b", "node-c"])
positions = [position for position, _ in nodes]

def locate(key: str) -> str:
    key_position = h(key)
    index = bisect.bisect_left(positions, key_position)
    if index == len(nodes):
        index = 0  # Halkanın başlangıcına sar
    return nodes[index][1]

print(locate("user:42"))
Kodda locate, anahtarın konumundan büyük veya eşit ilk düğümü seçer. index == len(nodes) koşulu ise dairesel yapının kritik ayrıntısıdır: son noktayı geçtiğinizde tekrar başlangıca dönersiniz.
Sanal düğümler neden gereklidir?
Salt fiziksel sunucuları halkaya birer kez koymak dengesiz dağılım üretebilir. Şanssız bir yerleşimde bir sunucu halkanın devasa bir bölümünü alırken diğeri neredeyse boşta kalır. Çözüm, her fiziksel sunucuyu çok sayıda sanal düğüm ile temsil etmektir: node-a#0, node-a#1 gibi.
| Özellik | Tek konumlu düğüm | Sanal düğümlü yapı |
|---|---|---|
| Yük dengesi | Hash dağılımına hassas | Daha dengeli |
| Kapasite ağırlıklandırma | Zor | Daha fazla sanal düğümle kolay |
| Yönetim maliyeti | Az | Biraz daha fazla metadata |
Örneğin güçlü bir makineye 200, zayıf olana 50 sanal düğüm vererek kapasiteye göre ağırlıklı dağıtım yapabilirsiniz. Consistent Hashing; Cassandra, Dynamo tarzı sistemler ve dağıtık cache katmanlarında bu nedenle çok değerlidir. Ancak veri replikasyonu, düğüm sağlığı ve yeniden dengeleme politikaları yine ayrıca tasarlanmalıdır. Halka dağıtımı çözer; operasyonel gerçekleri ise sizin mimariniz yönetir.
Yorumlar