İçindekiler
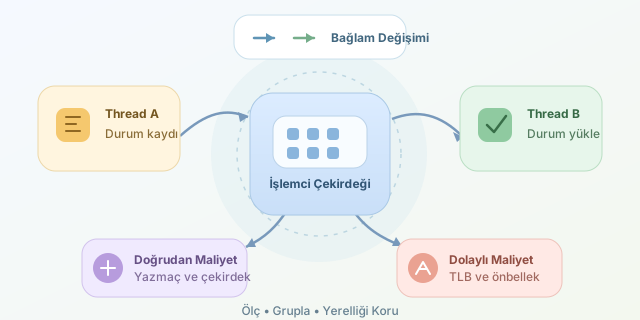
Bir işlemci çekirdeği bir thread’i durdurup diğerini çalıştırdığında ekranda hiçbir şey kıpırdamaz; ancak donanım ve işletim sistemi küçük bir bavul toplama töreni gerçekleştirir. Yazmaçlar saklanır, yeni yürütme bağlamı yüklenir, adres çevirileri gözden geçirilir ve önbellek düzeni sarsılabilir. Context switch, yararlı iş üretmeyen fakat çoklu görev için kaçınılmaz olan bu sürecin adıdır.
``
Context switch sırasında ne saklanır?
Her thread’in program sayacı, yığın işaretçisi ve genel amaçlı yazmaçları gibi kendine ait bir işlemci durumu bulunur. Zamanlayıcı çalışan thread’i değiştirdiğinde çekirdeğe geçilir; mevcut durum thread’in kontrol bloğuna kaydedilir ve sıradaki thread’in durumu geri yüklenir.
Tipik olarak şu bilgiler işleme katılır:
- Program sayacı ve stack pointer
- Genel amaçlı yazmaçlar
- Bayrak ve durum yazmaçları
- SIMD/FPU durumu
- Zamanlama ve muhasebe bilgileri
- Gerekirse sayfa tablosu bağlamı
Buradaki “kopyalama”, çoğunlukla yazmaçların çekirdek belleğindeki yapılara yazılmasıdır. Modern sistemler, büyük SIMD durumunu her geçişte körlemesine taşımak yerine tembel veya donanım destekli yöntemler kullanabilir.
Bir uygulamanın toplam çalışma süresini basitçe şöyle düşünebiliriz:
\[T_{toplam}=T_{yararlı}+N_{cs}\times(T_{doğrudan}+T_{dolaylı})\]Burada $N_{cs}$ context switch sayısıdır. Doğrudan maliyet, çekirdek kodu ve durum kaydetme süresidir. Dolaylı maliyet ise soğuyan cache, bozulan branch predictor geçmişi ve TLB kayıplarıdır. Çoğu zaman asıl canavar ikinci tarafta saklanır.
TLB neden önemlidir?
TLB, sanal adreslerin fiziksel adreslere çevrilmiş sonuçlarını tutan küçük ve hızlı bir önbellektir. Farklı süreçler farklı adres uzaylarına sahip olduğundan süreçler arası geçiş, eski çevirilerin geçersiz kılınmasını gerektirebilir. Bir sonraki bellek erişiminde TLB miss oluşursa işlemci sayfa tablolarını yürümek zorunda kalır.
Bununla birlikte “her context switch TLB’yi tamamen temizler” demek günümüzde doğru değildir. PCID ve ASID gibi etiketleme mekanizmaları, farklı adres uzaylarının TLB kayıtlarını birlikte koruyabilir. Aynı süreçteki thread’ler zaten adres uzayını paylaştığı için aralarındaki geçiş genellikle daha ucuzdur.
| Geçiş türü | Adres uzayı | TLB etkisi | Tahmini maliyet |
|---|---|---|---|
| Aynı thread, fonksiyon çağrısı | Aynı | Yok | Çok düşük |
| Aynı süreçte iki thread | Aynı | Genellikle sınırlı | Orta |
| Farklı süreçler | Farklı | PCID/ASID’ye bağlı | Daha yüksek |
| Farklı çekirdeğe göç | Değişebilir | Cache yerelliği de bozulur | En yüksek olabilir |
Maliyeti ölçmek
Aşağıdaki Linux örneği iki thread arasında eventfd kullanarak kontrollü biçimde sinyal dolaştırır. Amaç gerçek uygulamayı taklit etmek değil, çok sayıda uyandırma ve zamanlama geçişinin toplam süresini gözlemlemektir.
#include <pthread.h>
#include <sys/eventfd.h>
#include <stdint.h>
#include <unistd.h>

int a, b;
const int tekrar = 100000;

void *worker(void *arg) {
    uint64_t x;
    for (int i = 0; i < tekrar; i++) {
        read(a, &x, sizeof(x));
        write(b, &x, sizeof(x));
    }
    return NULL;
}

int main(void) {
    uint64_t x = 1;
    pthread_t t;
    a = eventfd(0, 0);
    b = eventfd(0, 0);
    pthread_create(&t, NULL, worker, NULL);

    for (int i = 0; i < tekrar; i++) {
        write(a, &x, sizeof(x));
        read(b, &x, sizeof(x));
    }
    pthread_join(t, NULL);
}
Program perf stat -e context-switches,cycles,instructions,cache-misses ./a.out ile çalıştırılabilir. Ölçüm sırasında CPU frekansı, çekirdek göçleri ve arka plan yükü sonuçları etkileyebileceğinden deneyi birkaç kez tekrarlamak gerekir.
Optimizasyon stratejileri
İlk hedef thread sayısını körlemesine artırmak değil, çalıştırılabilir thread sayısını çekirdek sayısıyla uyumlu tutmaktır. Thread pool kullanmak, kısa işler için sürekli thread oluşturup yok etmeyi önler. Küçük görevleri gruplamak zamanlayıcıya yapılan başvuruları azaltır.
CPU affinity, aynı thread’i belirli çekirdeklere bağlayarak cache yerelliğini koruyabilir; fakat dengesiz yükte boş çekirdeklerden yararlanmayı zorlaştırabilir. Kilit rekabetini azaltmak, gereksiz uyandırmaları engellemek ve bloklayan I/O için asenkron modeller kullanmak da etkilidir.
Sonuç olarak context switch tek başına kötü değildir; gereksiz ve aşırı olduğunda pahalıdır. En iyi optimizasyon, nanosanileri kovalamadan önce perf, profiler ve zamanlayıcı metrikleriyle gerçek darboğazı ölçmektir. Görünmez maliyet ancak ölçüldüğünde görünür olur.
Yorumlar