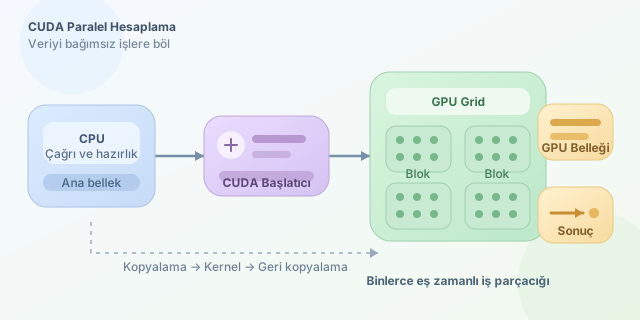
Bilgisayarınızdaki ekran kartı yalnızca oyunlardaki gölgeleri ve piksel efektlerini çizmek için çalışmaz; doğru programlandığında binlerce küçük işlemciyi aynı anda kullanan güçlü bir hesaplama laboratuvarına dönüşür. NVIDIA’nın CUDA platformu, C/C++ bilgisine sahip geliştiricilerin bu paralel güce erişmesini sağlar. Ancak CUDA’yı öğrenmenin anahtarı, daha fazla çekirdek demek yerine, problemi binlerce bağımsız işe nasıl bölebileceğinizi anlamaktır.
``
CUDA’nın teorik temeli, aynı komutun çok sayıda veri üzerinde yürütülmesine dayanan SIMT (Single Instruction, Multiple Threads) modelidir. Örneğin bir görüntüdeki her pikselin parlaklığını hesaplamak, her piksel için bağımsız bir görevdir. CPU bu işi birkaç güçlü çekirdekle sırayla veya sınırlı paralellikle yaparken GPU, binlerce iş parçacığını (thread) eş zamanlı planlayabilir.
| Özellik | CPU | GPU |
|---|---|---|
| Tasarım amacı | Karmaşık, dallanmalı işler | Yüksek hacimli paralel işler |
| Çekirdek yapısı | Az sayıda güçlü çekirdek | Çok sayıda daha küçük çekirdek |
| Uygun örnek | Dosya sistemi, kullanıcı arayüzü | Matris, görüntü, yapay zekâ |
| Bellek yaklaşımı | Düşük gecikme odaklı | Yüksek bant genişliği odaklı |
CUDA’da GPU üzerinde çalışan fonksiyonlara kernel denir. Bir kernel çağrısında kaç iş parçacığının çalışacağını siz belirlersiniz. İş parçacıkları bloklara, bloklar ise grid adlı daha büyük bir yapıya ayrılır. Her thread, threadIdx, blockIdx ve blockDim gibi yerleşik değişkenlerle kendi veri indeksini hesaplar. Tek boyutlu dizilerde yaygın indeks formülü şöyledir:
Bu formül, her iş parçacığına dizide benzersiz bir konum verir. Örneğin iki vektörü toplamak için her thread yalnızca bir elemanı işleyebilir. İşte minimal ama gerçek bir CUDA örneği:
#include <cuda_runtime.h>
#include <iostream>

__global__ void vektorTopla(const float* a, const float* b, float* c, int n) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;

    if (i < n) {
        c[i] = a[i] + b[i];
    }
}

int main() {
    const int n = 1 << 20;
    const int bytes = n * sizeof(float);
    float *d_a, *d_b, *d_c;

    cudaMalloc(&d_a, bytes);
    cudaMalloc(&d_b, bytes);
    cudaMalloc(&d_c, bytes);

    int threadSayisi = 256;
    int blokSayisi = (n + threadSayisi - 1) / threadSayisi;
    vektorTopla<<<blokSayisi, threadSayisi>>>(d_a, d_b, d_c, n);

    cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);
}
Buradaki __global__ anahtar sözcüğü, fonksiyonun CPU tarafından çağrılıp GPU’da çalıştırılacağını belirtir. <<<blokSayisi, threadSayisi>>> yazımı ise CUDA’ya çalışma konfigürasyonunu verir. Sınır kontrolü olan if (i < n) şartı kritik önemdedir: Son blok her zaman tamamen dolu olmayabilir ve dizinin dışına yazmak istemeyiz.
Elbette GPU’ya iş vermenin de maliyeti vardır. Veriler çoğunlukla CPU belleğinden GPU’nun global belleğine kopyalanır. Toplam süre kabaca şu şekilde düşünülebilir:
\[T_{toplam} = T_{kopyalama} + T_{kernel} + T_{geri\_kopyalama}\]Bu nedenle birkaç elemanlık bir listeyi GPU’ya göndermek çoğu zaman CPU’dan yavaştır. CUDA, büyük veri kümeleri ve yoğun hesaplama için parlar. Ayrıca ardışık bellek erişimi (coalesced access), paylaşımlı bellek (shared memory) kullanımı ve az sayıda dallanma, performansı dramatik biçimde etkiler.
Başlamak için NVIDIA sürücüsü, CUDA Toolkit ve nvcc derleyicisi yeterlidir. İlk hedefiniz vektör toplama gibi basit kernel’ler olmalı; ardından matris çarpımı, görüntü filtreleme veya parçacık simülasyonlarına geçebilirsiniz. CUDA’da hızın sırrı sihirli bir komutta değil, problemi paralel düşünme alışkanlığında saklıdır.
Yorumlar