İçindekiler
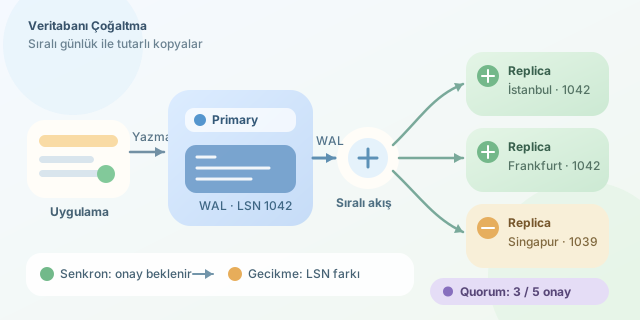
Bir kullanıcı profil fotoğrafını değiştirdiğinde bu değişikliğin İstanbul, Frankfurt ve Singapur’daki sunuculara ulaşması gerekir. Üstelik sunuculardan biri uyuklarken, ağ bağlantısı naz yaparken ve binlerce yeni işlem gelirken! Database replication, aynı verinin birden fazla sunucuda kopyalanmasını sağlayarak performans, erişilebilirlik ve felaket kurtarma avantajı sunar. Ancak kopyalamak kolay, bütün kopyaları tutarlı tutmak zordur. ``
Temel model: Primary ve replica
En yaygın yapıda bir primary sunucu yazma işlemlerini kabul eder. Replica adı verilen diğer sunucular, primary üzerindeki değişiklikleri takip eder. Uygulama yazmaları primary’ye, okuma sorgularını ise replica’lara göndererek yükü dağıtabilir.
Primary, her değişikliği doğrudan tablo satırı olarak göndermek yerine çoğunlukla Write-Ahead Log (WAL) veya transaction log içerisine kaydeder. Replica bu günlüğü alır ve işlemleri aynı sırayla uygular:
1. UPDATE users SET score = 42 WHERE id = 7
2. Primary değişikliği WAL'a yazar
3. WAL kaydı replica'lara iletilir
4. Replica aynı değişikliği yerel verisine uygular
Sıra önemlidir. Önce bakiyeyi artırıp sonra hesabı silmek ile önce hesabı silip sonra bakiyeyi artırmak aynı sonucu üretmez. Bu nedenle kayıtlara artan bir Log Sequence Number (LSN) atanır.
Senkron mu, asenkron mu?
| Model | Yazma ne zaman başarılı sayılır? | Avantaj | Risk |
|---|---|---|---|
| Senkron | Replica onayından sonra | Güçlü tutarlılık | Yüksek gecikme |
| Asenkron | Primary kaydettikten sonra | Hızlı yazma | Veri kaybı ve gecikmeli okuma |
| Yarı senkron | Belirli sayıda replica onaylayınca | Dengeli yaklaşım | Yapılandırma karmaşıklığı |
Asenkron replication sırasında replica birkaç saniye geride kalabilir. Kullanıcı profilini güncelledikten hemen sonra eski profilini görürse buna replication lag etkisi denir. Yaklaşık gecikme şöyle ifade edilebilir:
\[L = t_{replica\_apply} - t_{primary\_commit}\]$L$ büyüdükçe bayat veri okuma ihtimali artar. Çözümler arasında güncellemeden sonraki okumayı primary’ye yönlendirmek, kullanıcının son LSN değerini izlemek ve replica yetişene kadar beklemek bulunur.
Quorum: Çoğunluk ne diyorsa o
Tek bir primary arızalanırsa yeni liderin seçilmesi gerekir. Dağıtık sistemler burada quorum yaklaşımını kullanabilir. $N$ kopya, $W$ yazma onayı ve $R$ okuma katılımcısı için güçlü çakışma garantisi genellikle şu koşulla hedeflenir:
\[W + R > N\]Örneğin $N=5$, $W=3$ ve $R=3$ olduğunda okuma ve yazma kümeleri en az bir sunucuda kesişir. Fakat ağ ikiye bölünürse her iki tarafın da kendisini lider sanması, yani split-brain, felaket tarifidir. Raft ve Paxos gibi consensus algoritmaları yalnızca çoğunluğa ulaşan tarafın lider seçmesine izin verir.
Basit bir okuma yönlendirme örneği
Aşağıdaki Python kodu, kritik okumaları primary’ye; normal okumaları replica’lara gönderir:
import random

primary = 'db-primary'
replicas = ['db-replica-1', 'db-replica-2']

def select_database(is_critical=False):
    if is_critical:
        return primary
    return random.choice(replicas)

print(select_database(is_critical=True))
Bu yaklaşım ödeme sonrası bakiye kontrolü gibi hassas sorguların güncel veriyi görmesini sağlar. Ürün kataloğu gibi birkaç saniyelik gecikmeyi kaldırabilen sorgular replica’dan okunabilir.
Tutarlılık seviyeleri
| Seviye | Davranış | Uygun senaryo |
|---|---|---|
| Strong consistency | Her okuma en güncel yazmayı görür | Bankacılık, stok düşümü |
| Eventual consistency | Kopyalar zamanla eşitlenir | Beğeni ve görüntülenme sayıları |
| Read-your-writes | Kullanıcı kendi değişikliğini hemen görür | Profil ve ayar ekranları |
Replication sihirli bir “kopyala” düğmesi değildir; gecikme, hata toleransı ve tutarlılık arasında yapılan bilinçli bir pazarlıktır. İyi tasarım, her verinin aynı sertlikte kurallara ihtiyaç duymadığını kabul eder. Banka bakiyesi disiplin isterken bir gönderinin beğeni sayısı birkaç saniye sabredebilir. Kısacası doğru soru “Her şeyi nasıl anında eşitleriz?” değil, “Hangi veri ne kadar tutarlılık istiyor?” olmalıdır.
Yorumlar