İçindekiler
Bir televizyonun çekmediği kanaldaki karıncalanmayı düşünün. Şimdi bu rastgele piksellerin yavaşça bir kediye, uzay gemisine veya Van Gogh esintili bir manzaraya dönüştüğünü hayal edin. Denoising Diffusion Probabilistic Models, yani DDPM, tam olarak bunu yapar: Veriyi kontrollü biçimde gürültüye dönüştürmeyi öğrenir ve ardından zamanı tersine sararak gürültüden yeni görüntüler üretir. ``
Termodinamikten gelen temel fikir
Difüzyon, fiziksel sistemlerin zamanla daha düzensiz hâle gelmesini anlatır. Bir bardak suya damlatılan mürekkebin kendiliğinden yayılması bunun klasik örneğidir. Başlangıçtaki düzen kaybolurken sistemin entropisi artar. DDPM de gerçek bir görüntüye küçük miktarlarda Gauss gürültüsü ekleyerek benzer bir süreç kurar.
Model iki ayrı süreçten oluşur:
| Süreç | Yön | Amaç | Öğreniliyor mu? |
|---|---|---|---|
| İleri difüzyon | Görüntüden gürültüye | Veriyi aşamalı olarak bozmak | Hayır |
| Ters difüzyon | Gürültüden görüntüye | Gürültüyü aşamalı olarak temizlemek | Evet |
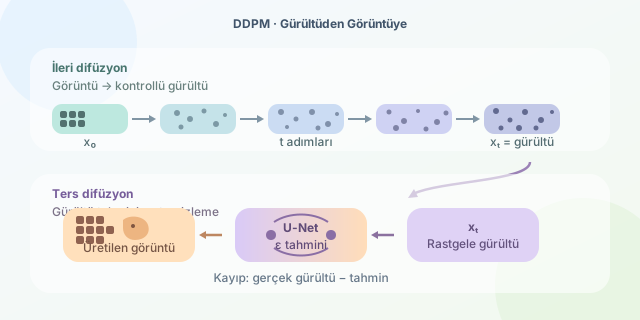
İleri süreç mürekkebin suya yayılması kadar kolaydır. Asıl marifet, yayılmış mürekkebi yeniden tek bir damlada toplamak gibi davranan ters süreçtedir.
İleri difüzyon: Görüntüyü kontrollü bozmak
Temiz görüntüyü $x_0$ ile gösterelim. Her $t$ adımında görüntüye, miktarı bir varyans çizelgesiyle belirlenen gürültü eklenir:
\[q(x_t\mid x_{t-1})=\mathcal{N}(x_t;\sqrt{1-\beta_t}x_{t-1},\beta_tI)\]Buradaki $\beta_t$, ilgili adımdaki gürültü miktarıdır. Küçük değerler görüntünün yavaşça bozulmasını sağlar. Güzel tarafı, yüzlerce adımı sırayla çalıştırmadan herhangi bir $t$ anına doğrudan sıçrayabilmemizdir:
\[x_t=\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon\]Burada $\alpha_t=1-\beta_t$, $\bar{\alpha}t=\prod{s=1}^{t}\alpha_s$ ve $\epsilon\sim\mathcal{N}(0,I)$ olur. İlk terim korunmuş görüntüyü, ikinci terim eklenen rastgeleliği temsil eder.
| Zaman | Görüntü bilgisi | Gürültü |
|---|---|---|
| $t=0$ | Çok yüksek | Yok |
| Orta adımlar | Kısmen görünür | Orta |
| $t=T$ | Neredeyse yok | Çok yüksek |
Ters süreç: Gürültüyü tahmin etmek
Model, $x_t$ görüntüsünü ve zaman adımı $t$ değerini alarak eklenmiş gürültüyü tahmin eder. Genellikle omurgada, farklı çözünürlüklerde ayrıntı yakalayabilen bir U-Net bulunur. Sinir ağı $\epsilon_\theta(x_t,t)$ tahminini üretir; bu tahmin kullanılarak biraz daha temiz olan $x_{t-1}$ hesaplanır.
Eğitim kaybı şaşırtıcı derecede sadedir:
\[L=\mathbb{E}_{x_0,t,\epsilon}\left[\lVert\epsilon-\epsilon_\theta(x_t,t)\rVert^2\right]\]Başka bir deyişle model, gerçek gürültü ile tahmin ettiği gürültü arasındaki karesel farkı küçültür. Görüntünün kendisini ezberlemek yerine her bozulma seviyesinde hangi parçanın rastgele olduğunu öğrenir.
Aşağıdaki PyTorch benzeri kod, tek bir eğitim adımının özünü gösterir:
import torch

# Her örnek için rastgele bir difüzyon zamanı seçilir.
t = torch.randint(0, total_steps, (images.size(0),), device=images.device)
noise = torch.randn_like(images)

# Kapalı formül sayesinde görüntü doğrudan x_t seviyesine taşınır.
noisy = sqrt_alpha_bar[t] * images
noisy += sqrt_one_minus_alpha_bar[t] * noise

# U-Net eklenen gürültüyü tahmin eder.
predicted_noise = model(noisy, t)
loss = torch.mean((noise - predicted_noise) ** 2)

optimizer.zero_grad()
loss.backward()
optimizer.step()
Üretim neden yavaş ama etkileyici?
Üretim sırasında süreç saf $x_T$ gürültüsüyle başlar. Model, yüzlerce veya binlerce küçük temizleme adımı uygular. GAN modelleri çoğunlukla tek geçişte sonuç üretirken DDPM daha sabırlıdır; adeta bir heykeltıraş gibi her adımda rastgeleliği biraz daha yontar.
Bu aşamalı yaklaşım yüksek çeşitlilik, kararlı eğitim ve güçlü görüntü kalitesi sağlar. Dezavantajı hesaplama maliyetidir. DDIM, latent diffusion ve gelişmiş örnekleyiciler adım sayısını azaltarak bu sorunu hafifletir. Sonuçta görünen sihir, aslında olasılık teorisi, termodinamik sezgi ve dikkatle eğitilmiş bir gürültü tahmincisinin zarif iş birliğidir.
Yorumlar