İçindekiler
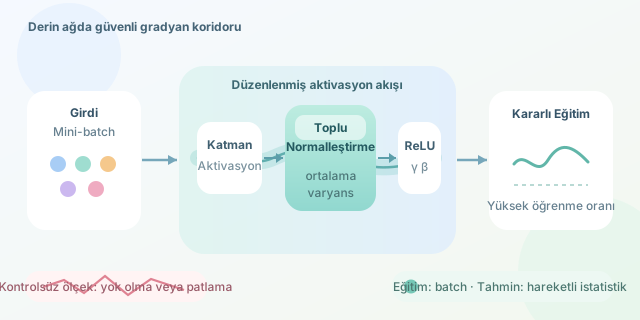
Derin bir sinir ağını eğitmek, onlarca kişilik bir kulaktan kulağa oyunu yönetmeye benzer: İlk katmandaki anlamlı sinyal, son katmana ulaşana kadar küçülebilir, büyüyebilir veya tamamen bozulabilir. Batch Normalization, yani Toplu Normalleştirme, katmanlar arasında dolaşan aktivasyonları daha düzenli ölçeklerde tutarak optimizasyonu kolaylaştırır. Böylece ağlar daha yüksek öğrenme oranlarıyla, daha kararlı ve çoğu zaman daha hızlı eğitilebilir. ``
Derin ağlarda sinyal neden bozulur?
Geri yayılım sırasında zincir kuralı uygulanır. Çok katmanlı bir ağdaki erken katmanın gradyanı kabaca şöyle düşünülebilir:
\[G = g_1 g_2 g_3 \cdots g_L\]Buradaki her $g_i$, ilgili katmanın yerel türevidir. Değerlerin çoğu 1’den küçükse çarpım hızla sıfıra yaklaşır ve gradyan yok olması ortaya çıkar. Değerler büyükse bu kez gradyan patlayabilir. Ağırlık dağılımlarındaki değişimler ayrıca sonraki katmanların sürekli farklı ölçeklerde girdiler görmesine neden olur.
Batch Normalization bu sorunların tamamını sihirli biçimde çözmez; ancak aktivasyon ölçeklerini denetleyerek gradyanların daha sağlıklı akabileceği bir ortam oluşturur. ReLU, uygun ağırlık başlatma ve artık bağlantılar gibi tekniklerle birlikte kullanıldığında etkisi daha belirgindir.
Batch Normalization nasıl çalışır?
Bir mini-batch içindeki $m$ adet aktivasyon için önce ortalama ve varyans hesaplanır:
\[mean = \frac{1}{m}\sum_{i=1}^{m}x_i\] \[variance = \frac{1}{m}\sum_{i=1}^{m}(x_i-mean)^2\]Ardından değerler normalize edilir ve öğrenilebilir iki parametreyle yeniden ölçeklenir:
\[normalized_i = \frac{x_i-mean}{\sqrt{variance+epsilon}}\] \[y_i = gamma \cdot normalized_i + beta\]Buradaki $epsilon$, sıfıra bölünmeyi önleyen küçük bir sabittir. $gamma$ ölçeği, $beta$ ise kaydırmayı öğrenir. Dolayısıyla Batch Normalization ağı her şeyi zorla standart normal dağılıma hapsetmez; model, ihtiyaç duyduğu dönüşümü yeniden kurabilir.
| Özellik | Batch Normalization olmadan | Batch Normalization ile |
|---|---|---|
| Aktivasyon ölçeği | Katmanlar arasında değişken | Daha kontrollü |
| Öğrenme oranı | Genellikle daha temkinli | Daha yüksek seçilebilir |
| Gradyan akışı | Kararsızlaşabilir | Çoğunlukla daha düzenli |
| Eğitimin hassasiyeti | Başlatmaya daha duyarlı | Görece daha dayanıklı |
| Ek hesaplama | Yok | Ortalama ve varyans hesabı var |
Eğitim ve tahmin arasındaki kritik fark
Eğitim sırasında o anki mini-batch’in istatistikleri kullanılır. Tahmin aşamasında ise tek örnek gelebileceğinden eğitim boyunca biriktirilen hareketli ortalama ve varyans devreye girer.
| Mod | Kullanılan istatistik |
|---|---|
| Eğitim | Mini-batch ortalaması ve varyansı |
| Değerlendirme | Biriktirilmiş hareketli istatistikler |
Bu nedenle PyTorch’ta değerlendirme öncesinde model.eval() çağrılmalıdır. Aksi hâlde model, tahmin sırasında da batch istatistikleri hesaplayarak tutarsız sonuçlar üretebilir.
PyTorch ile kullanım
Aşağıdaki ağda Batch Normalization, doğrusal katmandan sonra ve ReLU’dan önce uygulanır:
import torch.nn as nn

model = nn.Sequential(
    nn.Linear(128, 256),
    nn.BatchNorm1d(256),
    nn.ReLU(),
    nn.Linear(256, 10)
)

# Eğitim modu: mini-batch istatistikleri kullanılır.
model.train()

# Tahmin modu: hareketli istatistikler kullanılır.
model.eval()
Evrişimli ağlarda özellik kanallarını normalleştirmek için BatchNorm2d, zaman veya özellik tabanlı doğrusal verilerde ise çoğunlukla BatchNorm1d tercih edilir.
Her durumda iyi bir fikir mi?
Çok küçük batch boyutlarında ortalama ve varyans gürültülü olabilir. Bu durumda Layer Normalization veya Group Normalization daha kararlı seçeneklerdir. Transformer mimarilerinde de batch’ten bağımsız çalışabilen Layer Normalization yaygındır.
Özetle Batch Normalization, gradyan yok olmasını tek başına ortadan kaldıran bir kalkan değil, katmanlar arası sinyal trafiğini düzenleyen etkili bir trafik polisidir. Doğru konumlandırıldığında derin ağların eğitimini hızlandırır, optimizasyonu kararlı hâle getirir ve hiperparametre seçimindeki hassasiyeti azaltır.
Yorumlar