İçindekiler
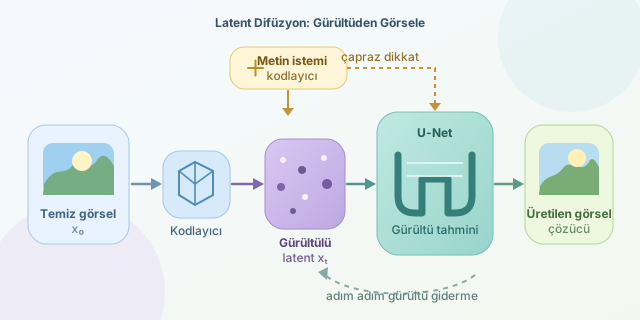
Bir televizyonun karıncalı ekranına uzun süre bakıp içinden bir kedi resmi çıkmasını beklemek pek mantıklı görünmeyebilir. Difüzyon modelleri ise tam olarak bunu yapar: Rastgele gürültüyle başlayan veriyi, öğrendikleri örüntüler sayesinde adım adım anlamlı bir görsele dönüştürür. Stable Diffusion ve benzeri üretken yapay zekâ sistemlerinin arkasındaki bu yaklaşım, kontrollü bir bozma ve onarma sürecine dayanır.
``
İleri difüzyon: Görseli bozmayı öğrenmek
Difüzyon modellerinin ilk aşaması ileri süreçtir. Eğitim verisindeki temiz bir görsele küçük miktarlarda Gaussian gürültüsü eklenir. Bu işlem yüzlerce veya binlerce adım tekrarlandığında görüntü, başlangıçtaki içeriğini kaybederek saf gürültüye yaklaşır.
Bir adımdaki bozulma kabaca şöyle ifade edilir:
\[x_t = \sqrt{α_t}x_{t-1} + \sqrt{1-α_t}ε\]Burada $x_{t-1}$ önceki görüntüyü, $x_t$ gürültü eklenmiş yeni görüntüyü, $ε$ ise normal dağılımdan örneklenen gürültüyü temsil eder. $α_t$, görüntünün ne kadarının korunacağını belirleyen katsayıdır.
Pratikte herhangi bir zaman adımına doğrudan ulaşmak da mümkündür:
\[x_t = \sqrt{ᾱ_t}x_0 + \sqrt{1-ᾱ_t}ε\]Bu özellik eğitimi hızlandırır; modelin bütün adımları sırayla çalıştırması gerekmez. Rastgele bir $t$ seçilir, temiz görsel o seviyede bozulur ve modele gürültüyü tahmin etme görevi verilir.
| Kavram | İleri süreç | Ters süreç |
|---|---|---|
| Başlangıç | Temiz görüntü | Rastgele gürültü |
| Hedef | Veriyi bozmak | Görüntüyü oluşturmak |
| İşlem | Gürültü ekleme | Gürültü tahmini ve çıkarma |
| Öğrenme gerekir mi? | Genellikle hayır | Evet |
Ters difüzyon: Karıncalardan anlam çıkarmak
Asıl sihir ters süreçte gerçekleşir. Sinir ağı, çoğunlukla U-Net benzeri bir mimari kullanarak $x_t$ içindeki gürültüyü tahmin eder. Tahmin edilen bölüm çıkarılır ve biraz daha temiz bir örnek elde edilir. Bu döngü tekrarlandıkça önce belirsiz şekiller, ardından nesneler, dokular ve ayrıntılar ortaya çıkar.
Modelin yaygın eğitim kaybı oldukça sadedir:
\[L = E[\Vert ε - ε_θ(x_t,t)\Vert ^2]\]$ε$ gerçekten eklenen gürültü, $ε_θ$ ise ağın tahminidir. İkisi arasındaki fark küçüldükçe model, gürültünün altında saklanan veri dağılımını daha iyi öğrenir. Yani model doğrudan “kedi nasıl çizilir?” sorusunu yanıtlamaz; “Bu görüntüde hangi bölüm gürültü?” sorusunda ustalaşır.
Aşağıdaki PyTorch benzeri kod, tek bir eğitim adımının temel mantığını gösterir:
import torch

# Temiz görüntüler ve rastgele zaman adımları
t = torch.randint(0, steps, (images.size(0),), device=images.device)
noise = torch.randn_like(images)

# Görüntüyü seçilen seviyede gürültülendir
noisy_images = (
    alpha_bar[t].sqrt().view(-1, 1, 1, 1) * images
    + (1 - alpha_bar[t]).sqrt().view(-1, 1, 1, 1) * noise
)

# Model eklenen gürültüyü tahmin eder
predicted_noise = model(noisy_images, t)
loss = torch.mean((predicted_noise - noise) ** 2)
loss.backward()
Kodda model temiz görüntüyü üretmeye çalışmaz. Eklenen gürültüyü tahmin eder; hata değeri de gerçek ve tahmini gürültü arasındaki karesel farktır.
Metin, latent uzay ve yönlendirme
Metinden görsel üreten sistemlerde metin, bir kodlayıcıyla sayısal temsile dönüştürülür. Bu temsil, çapraz dikkat mekanizmaları üzerinden gürültü giderme sürecini yönlendirir. Böylece “uzayda kahve içen robot” ifadesi, hangi görsel özelliklerin güçlendirileceğini belirler.
| Yaklaşım | Piksel difüzyonu | Latent difüzyon |
|---|---|---|
| Çalışma alanı | Doğrudan pikseller | Sıkıştırılmış temsil |
| Hesaplama maliyeti | Yüksek | Daha düşük |
| Ayrıntı kontrolü | Güçlü | Kod çözücüye bağlı |
| Yaygın kullanım | Araştırma modelleri | Stable Diffusion türleri |
Latent difüzyonda görüntü önce daha küçük bir özellik uzayına sıkıştırılır. Gürültü giderme burada yapılır, sonuç daha sonra piksel uzayına çözülür. Bu yöntem üretimi ciddi biçimde hızlandırır.
Sonuç olarak difüzyon modelleri, kaosu tek hamlede resme çevirmeyen sabırlı ressamlardır. Her adımda biraz gürültü siler, olasılıkları yeniden düzenler ve sonunda başlangıçta hiç var olmayan fakat öğrenilen veri dağılımıyla uyumlu bir görüntü oluştururlar.
Yorumlar