İçindekiler
İki metnin ne kadar benzediğini yalnızca ortak kelimeleri sayarak ölçmek yanıltıcı olabilir. Çünkü sıralama da anlam taşır: "programlama harikadır" ile "harikadır programlama" aynı kelimeleri içerse de dizilişleri farklıdır. En Uzun Ortak Alt Dizi (Longest Common Subsequence, LCS), iki dizideki elemanların sırasını koruyarak bulunabilen en uzun ortak yapıyı hesaplar. Metin karşılaştırma, DNA analizi, sürüm kontrol sistemleri ve dosya farkı araçlarının temelinde bu fikir bulunur.
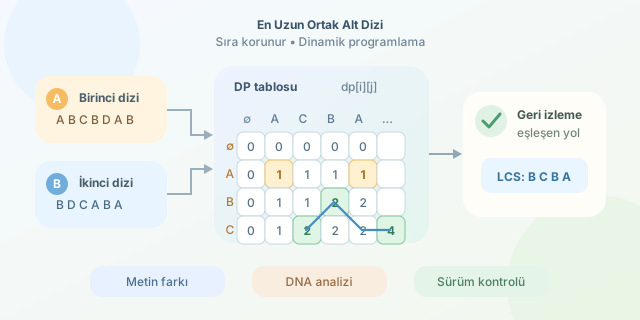
``
Önce kritik ayrımı netleştirelim: LCS, alt dize (substring) değil, alt dizidir (subsequence). Alt dizide karakterlerin veya kelimelerin yan yana olması gerekmez; yalnızca kendi iç sıraları korunmalıdır. Örneğin ABCBDAB ve BDCABA dizileri için olası bir LCS sonucu BCBA olabilir. Harfler kaynak dizilerde aralıklı görünse bile sıraları bozulmaz.
| Kavram | Yan yana olma şartı | Sıra korunur mu? | Örnek |
|---|---|---|---|
| Ortak alt dize | Evet | Evet | ABCDE ve XBCDY için BCD |
| Ortak alt dizi (LCS) | Hayır | Evet | ABCDE ve AXBYCZE için ABC |
| Kelime kümesi kesişimi | Hayır | Hayır | Sadece ortak öğeleri verir |
Neden Dinamik Programlama?
İki dizideki her olası karakter seçimini denemek, özellikle uzun metinlerde üstel maliyet üretir. Dinamik programlama bu problemi küçük alt problemlere ayırır ve her sonucu bir kez hesaplayıp saklar. Böylece tekrar tekrar aynı soruyu sormayız: “İlk i karakter ile ilk j karakter arasındaki en iyi ortak alt dizi kaç uzunlukta?”
dp[i][j], birinci dizinin ilk i karakteri ile ikinci dizinin ilk j karakteri için LCS uzunluğu olsun. Karakterler eşleşirse çözüm bir adım büyür:
Karakterler farklıysa, iki ihtimalden iyi olanı seçeriz: birinci dizinin son karakterini görmezden gelmek veya ikinci dizinin son karakterini görmezden gelmek.
\[dp[i][j] = \max(dp[i-1][j], dp[i][j-1])\]Başlangıç durumu da oldukça sezgiseldir: Dizilerden biri boşsa ortak alt dizi yoktur. Bu nedenle $dp[0][j] = dp[i][0] = 0$ olur.
Tabloyu Doldurma Mantığı
Örnek olarak A = "ABC" ve B = "AC" dizilerini düşünelim. İlk satır ve sütun boş dizi durumunu temsil eder. A karakterleri satırlarda, B karakterleri sütunlarda ilerler. A eşleştiğinde çapraz hücreye 1 ekleriz; B eşleşmezse üst ve sol hücrenin büyüğünü alırız. Son hücredeki değer 2 olur; yani LCS uzunluğu AC ile 2’dir.
Aşağıdaki Python kodu yalnızca uzunluğu değil, tablodan geriye yürüyerek ortak alt dizinin kendisini de üretir:
def lcs(a, b):
    m, n = len(a), len(b)
    dp = [[0] * (n + 1) for _ in range(m + 1)]

    for i in range(1, m + 1):
        for j in range(1, n + 1):
            if a[i - 1] == b[j - 1]:
                dp[i][j] = dp[i - 1][j - 1] + 1
            else:
                dp[i][j] = max(dp[i - 1][j], dp[i][j - 1])

    sonuc = []
    i, j = m, n
    while i > 0 and j > 0:
        if a[i - 1] == b[j - 1]:
            sonuc.append(a[i - 1])
            i, j = i - 1, j - 1
        elif dp[i - 1][j] >= dp[i][j - 1]:
            i -= 1
        else:
            j -= 1

    return ''.join(reversed(sonuc))

print(lcs("ABCBDAB", "BDCABA"))  # BCBA veya başka geçerli bir LCS
Bu yaklaşımın zaman karmaşıklığı $O(mn)$, bellek karmaşıklığı da $O(mn)$’dir. Yalnızca uzunluk isteniyorsa tabloyu iki satıra indirerek belleği $O(n)$ seviyesine çekebiliriz. Ancak dizinin kendisini geri kurmak için genellikle tam tablo, ya da daha gelişmiş Hirschberg algoritması tercih edilir.
LCS kusursuz bir “anlamsal benzerlik” ölçüsü değildir; eş anlamlı kelimeleri anlayamaz. Buna rağmen sıralı değişiklikleri görünür kıldığı için diff araçları ve biyoinformatik gibi alanlarda hâlâ son derece güçlü, klasik ve öğretici bir algoritmadır.
Yorumlar