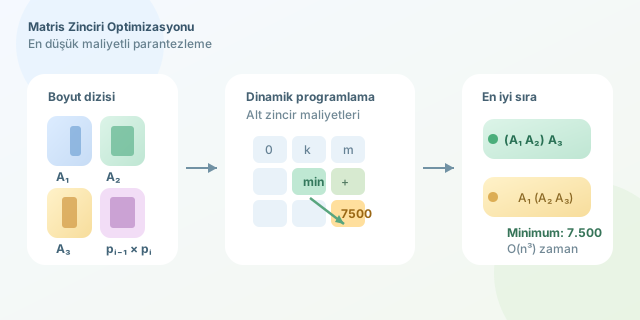
Birden fazla matrisi çarpmak, sonuç matrisi aynı kaldığı için ilk bakışta basit görünür. Ancak parantezlerin yeri, bilgisayarın yapacağı skaler çarpım sayısını dramatik biçimde değiştirebilir. Matris Zinciri Çarpımı problemi, matrisleri gerçekten çarpmaktan çok en ucuz çarpım sırasını bulmayı hedefler. Dinamik programlamanın “küçük en iyi çözümlerden büyük en iyi çözümü kur” fikrini öğrenmek için de klasik ve son derece öğretici bir örnektir. ``
Önce kritik ayrımı yapalım: Matris çarpımı birleşmelidir, yani $(AB)C = A(BC)$ sonucu verir. Buna karşın hesaplama maliyeti aynı değildir. $A$, $p \times q$; $B$, $q \times r$ boyutundaysa $AB$ sonucunu üretmek yaklaşık olarak
\[p \cdot q \cdot r\]skaler çarpım gerektirir. Dolayısıyla genişlik ve yükseklik değerleri, parantezleme stratejisinin kaderini belirler.
Örneğin $A_1: 10 \times 100$, $A_2: 100 \times 5$ ve $A_3: 5 \times 50$ olsun. İki olası yol vardır:
| Parantezleme | İlk işlem maliyeti | İkinci işlem maliyeti | Toplam |
|---|---|---|---|
| $(A_1A_2)A_3$ | $10\cdot100\cdot5=5.000$ | $10\cdot5\cdot50=2.500$ | 7.500 |
| $A_1(A_2A_3)$ | $100\cdot5\cdot50=25.000$ | $10\cdot100\cdot50=50.000$ | 75.000 |
Sonuç boyutu her iki durumda da $10 \times 50$ olmasına rağmen ikinci seçenek tam on kat pahalıdır. İşte dinamik programlama burada devreye girer: Tüm parantezleme ihtimallerini körlemesine üretmek yerine, alt zincirlerin en iyi maliyetlerini bir kez hesaplayıp saklarız.
Boyut dizisini $p$ ile gösterelim. $A_i$ matrisinin boyutu $p_{i-1} \times p_i$ olur. m[i][j], $A_i$ ile $A_j$ arasındaki zinciri çarpmanın minimum maliyetidir. Tek matris çarpılmayacağı için temel durum şöyledir:
Zinciri $k$ noktasından bölersek maliyetimiz aşağıdaki üç parçanın toplamıdır:
\[m[i][k] + m[k+1][j] + p_{i-1}p_kp_j\]Buradaki son terim, iki ara sonucu birbiriyle çarpmanın maliyetidir. Her $i, j$ çifti için tüm $k$ bölme noktalarını dener, en küçüğünü seçeriz. Aynı zamanda seçilen bölme noktasını saklarsak yalnızca maliyeti değil, ideal parantezlemeyi de geri kurabiliriz.
def matrix_chain_order(dimensions):
    n = len(dimensions) - 1
    cost = [[0] * n for _ in range(n)]
    split = [[0] * n for _ in range(n)]

    for length in range(2, n + 1):
        for i in range(n - length + 1):
            j = i + length - 1
            cost[i][j] = float("inf")

            for k in range(i, j):
                candidate = (cost[i][k] + cost[k + 1][j] +
                             dimensions[i] * dimensions[k + 1] * dimensions[j + 1])
                if candidate < cost[i][j]:
                    cost[i][j] = candidate
                    split[i][j] = k

    return cost[0][n - 1], split

minimum, decisions = matrix_chain_order([10, 100, 5, 50])
print(minimum)  # 7500
Kod, zincir uzunluğunu 2’den başlayarak büyütür. Böylece cost[i][j] hesaplanırken ihtiyaç duyduğu daha kısa alt zincirler zaten hazırdır. Bu yaklaşımın zaman karmaşıklığı $O(n^3)$, bellek karmaşıklığı ise $O(n^2)$’dir.
| Yaklaşım | Zaman maliyeti | Neden yetersiz veya güçlü? |
|---|---|---|
| Soldan sağa sabit çarpım | $O(n)$ karar | Çok hızlıdır, fakat optimal olmayabilir. |
| Tüm parantezlemeleri denemek | Üstel/Catalan büyümesi | Küçük zincirlerde bile hızla kontrolden çıkar. |
| Dinamik programlama | $O(n^3)$ | Tekrarlanan alt problemleri saklayarak güvenilir optimum üretir. |
Gerçek uygulamalarda veritabanı sorgu planlayıcıları, derleyiciler ve bilimsel hesaplama kütüphaneleri benzer maliyet modellerinden yararlanır. Ders nettir: Aynı matematiksel sonuç, aynı hesaplama maliyeti demek değildir; doğru işlem sırası performansın gizli çarpanıdır.
Yorumlar