İçindekiler
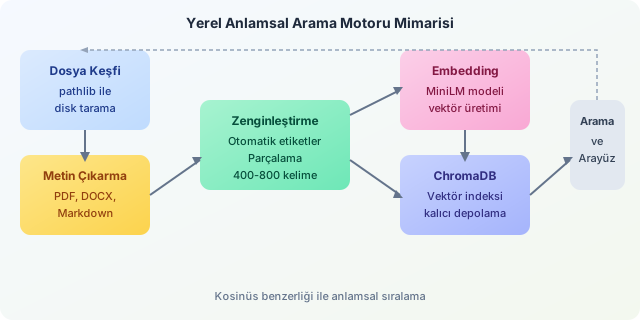
Klasik dosya arama araçları dosya adına ve tam anahtar kelime eşleşmesine bağımlıdır. Oysa toplantı notları diye aradığınızda adı 2025-03-14_musteri_gorusmesi.docx olan belgeyi bulmak istersiniz. Bu projede sabit diskteki dosyaları tarayan, metinlerini çıkaran, içeriklerinden otomatik etiket üreten ve internet bağlantısı olmadan anlamsal arama yapan yerel bir masaüstü arama motoru tasarlayacağız. Hedefimiz, diskinizi yalnızca dosyaların durduğu bir depo olmaktan çıkarıp bağlamı anlayan kişisel bir bilgi tabanına dönüştürmek.
``
Neden anahtar kelime araması yetmez?
Anahtar kelime yaklaşımı, sorgudaki karakter dizisini belgede arar. Bu nedenle eş anlamlılar, farklı çekimler ve dolaylı anlatımlar kaçırılır. Anlamsal arama ise hem sorguyu hem de belge parçalarını sayısal vektörlere, yani embedding‘lere dönüştürür. Anlamca yakın ifadelerin uzaydaki konumları da yakınlaşır.
Bir belgenin vektörü $\vec{d}$, kullanıcının sorgu vektörü $\vec{q}$ olsun. En yaygın benzerlik hesabı kosinüs benzerliğidir:
\[\operatorname{cosine}(\vec{q}, \vec{d}) = \frac{\vec{q} \cdot \vec{d}}{ \vert \vert \vec{q} \vert \vert \; \vert \vert \vec{d} \vert \vert }\]Sonuç 1’e yaklaştıkça anlamsal yakınlık artar. Böylece fatura ödemeleri sorgusu, içinde yalnızca ödeme, tahsilat veya mali belge geçen dosyaları da yakalayabilir.
| Özellik | Geleneksel arama | Anlamsal arama |
|---|---|---|
| Eşleşme ölçütü | Harf ve kelime | Anlam ve bağlam |
| Eş anlamlılar | Genellikle bulunamaz | Büyük oranda bulunur |
| İlk kurulum | Çok hızlı | İndeksleme gerektirir |
| Gizlilik | Araca bağlı | Tamamen yerel tutulabilir |
Mimarinin parçaları
Sistem dört temel aşamada çalışır: dosya keşfi, metin çıkarma, zenginleştirme ve indeksleme. pathlib ile disk taranır; PDF için PyMuPDF, DOCX için python-docx, düz metin ve Markdown için doğrudan okuma yapılır. Büyük dosyaları tek bir vektöre sıkıştırmak yerine yaklaşık 400-800 kelimelik parçalara bölmek gerekir. Çünkü arama sonucu belgenin tamamını değil, soruyla ilgili bölümünü göstermelidir.
Etiketleme iki katmanlı yapılabilir. İlk katman, dosya uzantısı, klasör adı, tarih ve sık geçen terimlerden kurallı etiketler üretir. İkinci katman ise yerel bir dil modeliyle sözleşme, finans, kod, eğitim gibi konu etiketleri önerir. Dil modeli zorunlu değildir; başlangıçta anahtar terim çıkarımı yeterlidir.
from pathlib import Path
from sentence_transformers import SentenceTransformer
import chromadb

model = SentenceTransformer("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
client = chromadb.PersistentClient(path="./veri_indeksi")
collection = client.get_or_create_collection("dosyalar")

def indeksle(dosya: Path, metin: str):
    parcalar = [metin[i:i + 2500] for i in range(0, len(metin), 2200)]
    vektorler = model.encode(parcalar).tolist()
    etiketler = ["pdf" if dosya.suffix == ".pdf" else "metin"]

    collection.add(
        ids=[f"{dosya}-{i}" for i in range(len(parcalar))],
        documents=parcalar,
        embeddings=vektorler,
        metadatas=[{"path": str(dosya), "tags": ",".join(etiketler)}] * len(parcalar)
    )
Bu fonksiyon, çıkarılmış metni örtüşen parçalara ayırır. Örtüşme, cümlenin veya fikrin tam sınırda bölünmesi durumunda bağlam kaybını azaltır. ChromaDB vektörleri diskte sakladığı için uygulama kapandıktan sonra da indeks kullanılabilir.
Arama, sıralama ve masaüstü deneyimi
Sorgu geldiğinde aynı modelle vektöre çevrilir ve en yakın $k$ parça alınır. Dosya yolu, kısa metin özeti, benzerlik puanı ve etiketler kullanıcıya sunulur. Arayüz için hızlı bir prototipte Streamlit; gerçek masaüstü hissi için PySide6 tercih edilebilir. Sonuçtaki dosyaya çift tıklamak, işletim sisteminin varsayılan uygulamasıyla açmalıdır.
| Bileşen | Hafif başlangıç | Gelişmiş seçenek |
|---|---|---|
| Metin çıkarma | PyMuPDF, python-docx | Apache Tika |
| Embedding | MiniLM | BGE-M3 veya E5 |
| Vektör veritabanı | ChromaDB | Qdrant |
| Arayüz | Streamlit | PySide6 |
Son olarak artımlı indeksleme ekleyin: dosyanın değiştirilme zamanı ve içerik özeti saklanır, değişmeyen dosya yeniden işlenmez. Ayrıca gizli klasörleri varsayılan olarak dışarıda bırakın, indeks klasörünü şifreleyin ve hangi dizinlerin taranacağını kullanıcıya seçtirin. Böylece proje hem hızlı hem de mahremiyete saygılı bir dijital kütüphaneciye dönüşür.
Yorumlar