İçindekiler
Bir sosyal medya gönderisi, ödeme işlemi veya kargo kaydı oluşturduğunuzu düşünün. Sistem, bu kayda benzersiz bir kimlik vermeli; üstelik aynı anda çalışan milyonlarca makine birbirinden habersiz ID üretiyor olabilir. Tek bir veritabanı sayacına güvenmek kolaydır, ancak ölçek büyüyünce o masum sayaç sistemin kapısındaki uzun kuyruğa dönüşür. Distributed ID üretiminin amacı, koordinasyonu azaltırken çakışmayan, hızlı ve mümkünse sıralanabilir kimlikler oluşturmaktır.
``
İyi Bir Distributed ID Nasıl Olmalı?
Her sistemin beklentisi farklı olsa da ideal bir ID üreticisi şu özelliklerin çoğunu sağlamaya çalışır:
- Benzersizlik: İki kayıt aynı ID’yi almamalıdır.
- Yüksek hız: Ağ çağrısı veya merkezi kilit gerektirmemelidir.
- Yatay ölçeklenebilirlik: Yeni makineler rahatça eklenebilmelidir.
- Yaklaşık sıralanabilirlik: Yeni kayıtların ID’leri genellikle daha büyük olmalıdır.
- Kompaktlık: ID, indeksleri ve ağ paketlerini gereksiz yere şişirmemelidir.
Bu hedeflerin tamamını kusursuz biçimde sağlamak zordur. ID tasarımı da dağıtık sistemlerin klasik “bir özelliği al, diğerini dikkatle yönet” oyunudur.
Yaygın Yaklaşımların Karşılaştırması
| Yöntem | Merkezi koordinasyon | Sıralanabilirlik | Boyut | Temel risk |
|---|---|---|---|---|
| Veritabanı sayacı | Yüksek | Evet | Genellikle 64 bit | Darboğaz ve tek hata noktası |
| UUID v4 | Yok | Hayır | 128 bit | Büyük ve rastgele indeksler |
| UUID v7 | Yok | Evet | 128 bit | Görece büyük depolama |
| Snowflake | Düşük | Evet | 64 bit | Saat ve makine kimliği yönetimi |
| Segment tahsisi | Aralıklı | Evet | 64 bit | Segment servisinin yönetimi |
UUID v4, 122 rastgele bit kullanır. Yaklaşık $n$ adet ID üretildiğinde çakışma olasılığı doğum günü problemiyle tahmin edilebilir:
\[P(çakışma) \approx 1-e^{-\frac{n(n-1)}{2\cdot 2^{122}}}\]Olasılık inanılmaz küçüktür ama matematiksel olarak sıfır değildir. Ayrıca rastgele değerler, B-tree indekslerinde sayfa bölünmelerine ve düşük önbellek verimliliğine yol açabilir.
Snowflake Mantığı
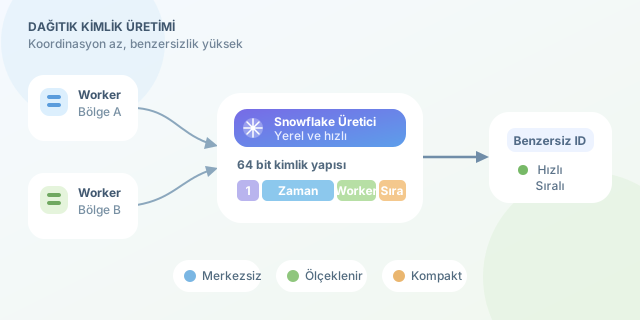
Twitter tarafından popülerleştirilen Snowflake yaklaşımı, 64 bitlik alanı parçalara ayırır. Örnek bir yerleşim şöyledir:
| Alan | Bit | Görevi |
|---|---|---|
| İşaret | 1 | Pozitif sayı üretmek |
| Zaman damgası | 41 | Epoch’tan geçen milisaniye |
| Worker ID | 10 | Makine veya süreç kimliği |
| Sıra numarası | 12 | Aynı milisaniyedeki kayıt sırası |
12 bit sıra alanı sayesinde bir worker, milisaniyede $2^{12}=4096$ ID üretebilir. 10 bit worker alanı ise $2^{10}=1024$ üreticiye izin verir. Teorik toplam kapasite saniyede yaklaşık:
\[4096 \times 1024 \times 1000 \approx 4.19 \text{ milyar ID}\]Basitleştirilmiş bir JavaScript uygulaması şöyle yazılabilir:
class Snowflake {
  constructor(workerId) {
    if (workerId < 0 || workerId > 1023) throw new Error("Geçersiz worker");
    this.workerId = BigInt(workerId);
    this.epoch = 1704067200000n;
    this.lastTime = -1n;
    this.sequence = 0n;
  }

  nextId() {
    let now = BigInt(Date.now());
    if (now < this.lastTime) throw new Error("Saat geriye gitti");

    if (now === this.lastTime) {
      this.sequence = (this.sequence + 1n) & 4095n;
      if (this.sequence === 0n) {
        while ((now = BigInt(Date.now())) <= this.lastTime) {}
      }
    } else {
      this.sequence = 0n;
    }

    this.lastTime = now;
    return ((now - this.epoch) << 22n) |
           (this.workerId << 12n) |
           this.sequence;
  }
}
Kod; zamanı üst bitlere, worker kimliğini orta bitlere ve milisaniye içi sayacı alt bitlere yerleştirir. Böylece merkezi servise her ID için danışılmaz.
Peki Milyonlarca Makine?
Tek bir Snowflake düzeni milyon worker’ı doğrudan taşıyamaz; worker alanı büyütülürse zaman veya sıra alanından fedakârlık gerekir. Büyük sistemler bu nedenle bölgeleri, veri merkezlerini ve worker’ları hiyerarşik bit alanlarına böler ya da her kümeye ayrı ID aralıkları tahsis eder.
En tehlikeli konu saat gerilemesidir. NTP düzeltmesi veya sanal makine taşınması zamanı geriye götürebilir. Üretici bu durumda bekleyebilir, hata verebilir ya da mantıksal saat kullanabilir. Worker ID’lerinin yanlışlıkla tekrar atanması da çakışma yaratır; bu kimlikler ZooKeeper, etcd veya Kubernetes üzerinden kiralanabilir.
Sonuç olarak sihirli tek çözüm yoktur: rastgelelik kolaylık, Snowflake kompaktlık ve sıralama, segment tahsisi ise kontrollü ölçek sunar. Doğru seçim; trafik miktarı, indeks davranışı, saat güvenilirliği ve operasyon ekibinin sabrına bağlıdır.
Yorumlar