İçindekiler
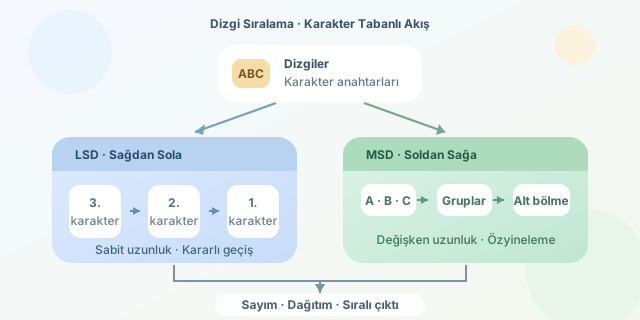
Bir sözlükteki milyonlarca kelimeyi sıralamanız gerektiğini düşünün. Klasik algoritmalar kelimeleri tekrar tekrar karşılaştırırken LSD ve MSD, karakterleri doğrudan anahtar olarak kullanır. Böylece “hangisi küçük?” sorusunu sürekli sormak yerine karakterlerin dağılımından yararlanırlar. Sonuç, uygun koşullarda karşılaştırmalı sıralamalardan belirgin biçimde daha hızlı çalışan bir yaklaşımdır.
``
Karşılaştırma Olmadan Sıralama Fikri
Quick Sort, Merge Sort ve Heap Sort gibi klasik algoritmalar karşılaştırma tabanlıdır. Bu algoritmaların genel alt sınırı $\Omega(N \log N)$ karşılaştırmadır. Dizgi sıralamada her karşılaştırma birden fazla karakterin incelenmesini gerektirebildiği için gerçek maliyet daha da büyüyebilir.
Anahtar-indeks sayımı ise karakterleri, örneğin ASCII kodlarını, küçük tam sayılara dönüştürür. Alfabe büyüklüğü $R$, eleman sayısı $N$ olduğunda tek karakter için temel süreç şöyledir:
- Her karakterin kaç kez geçtiğini say.
- Sayımları başlangıç indekslerine dönüştür.
- Öğeleri yardımcı diziye dağıt.
- Sonucu ana diziye geri kopyala.
Bu işlemin zaman karmaşıklığı $O(N + R)$ olur. Buradaki önemli ayrıntı, dağıtımın kararlı olmasıdır: Aynı karaktere sahip öğelerin önceki göreli sırası korunur.
def counting_sort_by_char(words, index, alphabet_size=256):
    count = [0] * (alphabet_size + 1)
    output = [None] * len(words)

    for word in words:
        code = ord(word[index])
        count[code + 1] += 1

    for r in range(alphabet_size):
        count[r + 1] += count[r]

    for word in words:
        code = ord(word[index])
        output[count[code]] = word
        count[code] += 1

    return output
Bu yardımcı fonksiyon, sabit bir karakter konumuna göre kararlı sıralama yapar. count dizisindeki bir hücre frekansı, ön toplam işleminden sonra ise başlangıç konumunu temsil eder.
LSD: Sağdan Sola İlerlemek
LSD, yani Least Significant Digit, en sağdaki karakterden başlar ve sola doğru ilerler. Genellikle tüm anahtarların aynı uzunlukta olduğu durumlarda kullanılır. Plaka kodları, sabit uzunluklu kimlikler ve tarih biçimleri iyi örneklerdir.
def lsd_sort(words, width):
    result = list(words)
    for index in range(width - 1, -1, -1):
        result = counting_sort_by_char(result, index)
    return result

codes = ['B12', 'A90', 'B01', 'A12']
print(lsd_sort(codes, 3))
Sağdan başlanmasının nedeni kararlılıktır. Son basamağa göre oluşan düzen, daha önemli bir karakter işlendiğinde aynı karakterli grupların içinde korunur. $W$ karakterli $N$ dizgi için yaklaşık maliyet $O(W(N + R))$ seviyesindedir.
MSD: Soldan Başlayan Böl ve Yönet
MSD, yani Most Significant Digit, önce en soldaki karakteri işler. Ardından aynı karakterle başlayan grupları kendi içlerinde özyinelemeli olarak sıralar. Değişken uzunluktaki kelimelerde özel bir “karakter yok” değeri kullanılır.
Örneğin ar, ara ve armut karşılaştırılırken kısa kelimenin bittiğini gösteren değer, gerçek karakterlerden küçük kabul edilir. Böylece ar, diğer ikisinin önüne gelir.
| Özellik | LSD | MSD |
|---|---|---|
| Başlangıç yönü | Sağdan sola | Soldan sağa |
| Uygun anahtarlar | Sabit uzunluklu | Değişken uzunluklu |
| Temel yapı | Yinelemeli geçiş | Özyinelemeli bölme |
| Güçlü yanı | Basit ve öngörülebilir | Gereksiz karakterleri atlayabilir |
| Zayıf yanı | Her karakteri işler | Küçük gruplarda ek yük oluşturur |
Ne Zaman Daha Hızlıdır?
Karşılaştırmalı sıralama yaklaşık $N \log N$ adet karar verir; üstelik ortak ön eke sahip dizgilerde aynı karakterleri defalarca okuyabilir. LSD ve MSD ise alfabe küçükken karakterleri kovalar gibi doğrudan kutulara dağıtır. Özellikle $R$ sabit ve anahtar uzunluğu sınırlıysa doğrusal davranışa yaklaşırlar.
Bununla birlikte Unicode gibi çok büyük alfabelerde doğrudan devasa sayım dizileri kullanmak bellek israfına dönüşebilir. Küçük veri kümelerinde de Python’ın yerleşik sorted fonksiyonu, düşük sabit maliyetleri sayesinde daha hızlı olabilir. Kısacası LSD düzenli veri için güvenilir bir maratoncu, MSD ise ortak önekleri ustaca eleyen çevik bir sprinterdir.
Yorumlar