İçindekiler
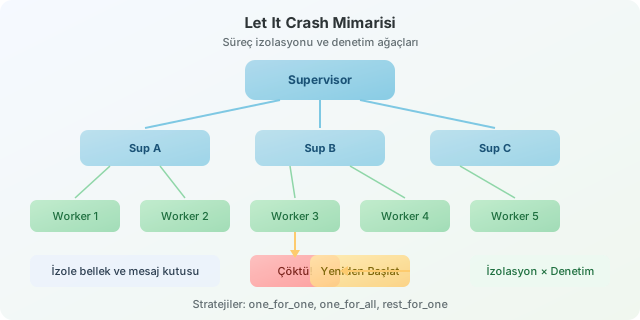
Bir web sunucusunun, ödeme işleyicisinin veya mesajlaşma sisteminin hata alınca tamamen durması korkutucudur. Elixir ise bu korkuyu farklı bir tasarım yaklaşımıyla karşılar: Her hatayı tek tek engellemeye çalışmak yerine, hatalı küçük parçayı kontrollü biçimde öldürür ve güvenilir bir üst süreç aracılığıyla yeniden başlatır. Bu yaklaşımın adı let it crash felsefesidir. İlk bakışta cesur, hatta tehlikeli görünen bu fikir; Erlang VM’in süreç izolasyonu, denetim ağaçları ve hata yayılımı mekanizmaları sayesinde oldukça pratiktir. ``
“Çökmeye izin ver” tam olarak ne demektir?
Let it crash, uygulamanın rastgele çökmesini kabullenmek değildir. Asıl fikir şudur: Bir süreç geçersiz bir durumda kalmışsa, onu karmaşık if, try/rescue ve bayraklarla onarmaya uğraşmak yerine sonlandırın; ardından sistemi bilen bir supervisor onu temiz durumla yeniden başlatsın.
Elixir süreçleri işletim sistemi süreçleri değildir. BEAM üzerinde çalışan, çok hafif ve izole aktörlerdir. Her birinin kendi belleği ve mesaj kutusu bulunur. Bu nedenle bir sürecin çökmesi, varsayılan olarak komşusunun belleğini bozmaz. Sistem dayanıklılığı kabaca şu çarpımla düşünülebilir:
\[Dayanıklılık = İzolasyon \times Denetim \times Güvenli\ Yeniden\ Başlatma\]Bir GenServer, örneğin dış API’den beklenmedik veri aldığında durumunu anlamsız hâle getirebilir. Hatanın kaynağını saklayıp bozuk durumla devam etmek yerine süreç kapanır. Bağlı olduğu supervisor, belirlenen stratejiye göre yeni bir örnek başlatır.
| Geleneksel savunmacı yaklaşım | Let it crash yaklaşımı |
|---|---|
| Her fonksiyonda hata kontrolü birikir | Beklenmeyen durum merkezi olarak ele alınır |
| Bozuk state ile devam etme riski vardır | Yeni süreç temiz state ile başlar |
| Hata ayıklama bazen zorlaşır | Crash raporları hatayı görünür kılar |
| Kritik hatalar gizlenebilir | Kritik hatalar kontrollü olarak yayılır |
OTP: Güvenlik ağı supervisor’lardır
OTP, Elixir ve Erlang ekosisteminin olgun tasarım desenleri koleksiyonudur. Bu koleksiyonun yıldızı supervision tree yapısıdır. Uygulamanın en üstünde bir supervisor bulunur; onun altında işçiler, başka supervisor’lar ve servis süreçleri yer alır. Böylece hata, ağacın ilgili dalında yönetilir.
defmodule Counter do
  use GenServer

  def start_link(_opts), do: GenServer.start_link(__MODULE__, 0, name: __MODULE__)
  def increment, do: GenServer.call(__MODULE__, :increment)

  @impl true
  def init(initial_value), do: {:ok, initial_value}

  @impl true
  def handle_call(:increment, _from, count) when count < 3 do
    {:reply, count + 1, count + 1}
  end

  def handle_call(:increment, _from, _count) do
    raise "Sayaç beklenmeyen sınıra ulaştı"
  end
end
Bu örnekte dördüncü çağrı süreci çökertecektir. Kodun amacı hatayı yutmak değildir: hatalı state’i açıkça sonlandırmaktır. Uygulama supervisor’ına bu çalışanı eklersek süreç otomatik yeniden doğar:
children = [
  {Counter, []}
]

Supervisor.start_link(children, strategy: :one_for_one)
` :one_for_one` stratejisinde yalnızca çöken çocuk yeniden başlatılır. Ancak bağımlı süreçler varsa farklı stratejiler daha anlamlı olabilir.
| Strateji | Çökme sonrası davranış | Uygun senaryo |
|---|---|---|
:one_for_one |
Sadece hatalı çocuk başlar | Bağımsız işçiler |
:one_for_all |
Tüm kardeşler yeniden başlar | Ortak state kullanan servisler |
:rest_for_one |
Sonraki kardeşler yeniden başlar | Başlatma sırası bağımlılıkları |
Her hatada çökülür mü?
Hayır. Beklenen, kullanıcı kaynaklı veya kurtarılabilir hatalar normal dönüş değerleriyle ele alınmalıdır: {:error, :not_found} gibi. Let it crash; programlama hataları, bozulmuş iç durum, karşılanmayan varsayımlar ve yeniden denemeyle temizlenebilecek geçici arızalar için güçlüdür. Ayrıca supervisor’lar sonsuz çökme döngüsünü önlemek amacıyla belirli süre içindeki yeniden başlatma sayısını sınırlar.
Bu yaklaşımın sırrı “hata yokmuş gibi davranmak” değil, hatayı izole etmek, görünür kılmak ve doğru kapsamda toparlanmaktır. Elixir’de sağlam sistemler, hiç çökmeyen süreçlerden değil; çöktüğünde ne yapacağını bilen süreç ailelerinden oluşur.
Yorumlar