İçindekiler
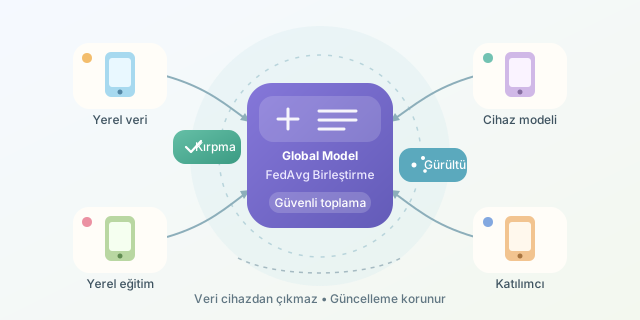
Telefonunuzun yazdığınız kelimeleri tahmin etmeyi öğrendiğini, ancak mesajlarınızın hiçbir zaman merkezi bir sunucuya gönderilmediğini düşünün. Federated Learning, yani federe öğrenme, tam olarak bu fikri hayata geçirir: Veriyi modele taşımak yerine modeli veriye götürür. Diferansiyel gizlilik ise paylaşılan model güncellemelerinden kişisel bilgilerin çıkarılmasını matematiksel olarak zorlaştırır.
``
Federe öğrenme nasıl çalışır?
Klasik makine öğrenmesinde kullanıcı verileri merkezi bir veri tabanında toplanır ve model burada eğitilir. Federe öğrenmede sunucu, mevcut global modeli seçilen cihazlara yollar. Her cihaz modeli kendi yerel verisiyle birkaç tur eğitir ve yalnızca hesapladığı ağırlık güncellemesini sunucuya gönderir.
Sunucu, bu güncellemeleri genellikle Federated Averaging (FedAvg) algoritmasıyla birleştirir:
\[w_{t+1} = \sum_{k=1}^{K} \frac{n_k}{N} w_{t+1}^{(k)}\]Burada $w_{t+1}^{(k)}$, $k$ numaralı cihazın güncellediği ağırlıkları; $n_k$, cihazdaki örnek sayısını; $N$ ise katılan cihazlardaki toplam örnek sayısını temsil eder. Daha fazla veriye sahip cihazın katkısı doğal olarak daha yüksek olur.
| Yaklaşım | Veri nerede? | Sunucuya giden | Temel risk |
|---|---|---|---|
| Merkezi eğitim | Sunucuda | Ham kullanıcı verisi | Veri tabanı sızıntısı |
| Federe öğrenme | Kullanıcı cihazında | Model güncellemesi | Güncellemeden bilgi çıkarımı |
| Federe öğrenme + DP | Kullanıcı cihazında | Gürültülü güncelleme | Kontrollü doğruluk kaybı |
Güncellemeler gerçekten güvenli mi?
Ham verinin gönderilmemesi tek başına kusursuz gizlilik sağlamaz. Saldırganlar gradyanlardan eğitim örneklerini yaklaşık olarak yeniden oluşturabilir veya belirli bir kullanıcının eğitime katılıp katılmadığını tahmin edebilir. İşte diferansiyel gizlilik, kısaca DP, burada devreye girer.
Bir mekanizma $M$, komşu iki veri kümesi $D$ ve $D’$ için şu koşulu sağlıyorsa $(\varepsilon, \delta)$-diferansiyel gizlidir:
\[P[M(D) \in S] \leq e^{\varepsilon}P[M(D') \in S] + \delta\]Komşu veri kümeleri yalnızca bir kullanıcının eklenmesi veya çıkarılması bakımından farklıdır. Küçük $\varepsilon$ daha güçlü gizlilik, fakat çoğunlukla daha fazla gürültü ve daha düşük model doğruluğu demektir. $\delta$ ise ideal garantinin çok küçük bir olasılıkla aşılmasına izin verir.
Kırpma ve gürültü ekleme
Cihaz güncellemeleri önce norm sınırı $C$ ile kırpılır. Böylece tek bir kullanıcının global modele yapabileceği maksimum etki kontrol edilir:
\[\bar{g}_k = g_k \cdot \min\left(1, \frac{C}{\lVert g_k \rVert_2}\right)\]Ardından toplama Gaussian gürültüsü eklenir. Aşağıdaki basitleştirilmiş Python kodu bu iki adımı gösterir:
import numpy as np

def privatize_update(update, clip_norm=1.0, noise_scale=0.2):
    # Güncellemenin etkisini belirlenen üst sınırda tutar.
    norm = np.linalg.norm(update)
    clipped = update * min(1.0, clip_norm / (norm + 1e-12))

    # Bireysel katkının ayırt edilmesini zorlaştırır.
    noise = np.random.normal(
        loc=0.0,
        scale=noise_scale * clip_norm,
        size=update.shape
    )
    return clipped + noise
Gerçek sistemlerde gürültü her cihazda veya güvenli toplama sonrasında sunucuda uygulanabilir. Secure Aggregation kullanıldığında sunucu tek tek güncellemeleri göremez; yalnızca toplam sonucu elde eder. Bu teknik DP’nin alternatifi değil, güçlü bir tamamlayıcısıdır.
Milyonlarca cihaz neden zorlu?
Cihazların işlem gücü, bağlantı kalitesi ve veri dağılımları farklıdır. Bir telefonda gece çekilmiş fotoğraflar, diğerinde gündüz görüntüleri bulunabilir; yani veriler çoğunlukla bağımsız ve özdeş dağılımlı değildir. Ayrıca her turda cihazların yalnızca küçük bir bölümü çevrim içidir.
| Karar | Avantaj | Bedel |
|---|---|---|
| Daha küçük $\varepsilon$ | Güçlü gizlilik | Daha fazla doğruluk kaybı |
| Büyük kırpma sınırı | Faydalı sinyal korunur | Kullanıcı etkisi artar |
| Fazla eğitim turu | Model gelişebilir | Gizlilik bütçesi tüketilir |
| Güvenli toplama | Güncellemeleri saklar | İletişim maliyeti yaratır |
Sonuç olarak federe öğrenme veriyi cihazda tutar, diferansiyel gizlilik ise modelin veriyi istemeden ezberlemesini sınırlar. İkisi güvenli toplama, şifreli iletişim ve düzenli gizlilik muhasebesiyle birleştiğinde milyonlarca kullanıcıdan öğrenen; ancak tek bir kullanıcı hakkında mümkün olduğunca az şey söyleyen dev modeller kurulabilir.
Yorumlar