İçindekiler
Milyarlarca parametreli bir dil modelini yeniden eğitmeden belirli bir göreve uyarlamak mümkün mü? Few-shot prompting, modele yalnızca birkaç doğru örnek göstererek bunu yapmamızı sağlar. Bir bakıma modele uzun bir kullanım kılavuzu vermek yerine, “Bak, ilk ikisini ben çözdüm; üçüncüsünü de sen yap” deriz. Üstelik çoğu zaman üç iyi örnek, üç sayfalık açıklamadan daha etkili olabilir.
``
Few-shot prompting nedir?
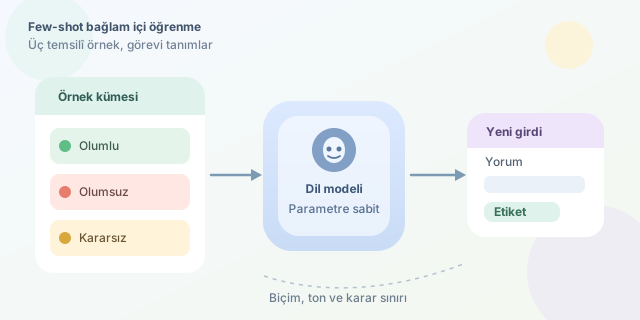
Few-shot prompting, bir görevin nasıl yapılacağını modelin girdisine yerleştirilen az sayıdaki örnek üzerinden tarif etme tekniğidir. Modelin parametreleri değişmez; öğrenme, yalnızca mevcut bağlam penceresi içinde gerçekleşir. Bu nedenle süreç gerçek bir eğitimden ziyade bağlam içi öğrenme olarak adlandırılır.
Bir dil modeli, sıradaki parçanın olasılığını yaklaşık olarak şöyle hesaplar:
\[P(y \mid x, E)\]Burada $x$ yeni girdi, $y$ beklenen çıktı ve $E$ ise prompt içine koyduğumuz örnekler kümesidir. Örnekler modele yalnızca cevabı değil; biçimi, tonu, sınıfları ve karar sınırlarını da sezdirir.
| Yaklaşım | Verilen bilgi | Güçlü yanı | Zayıf yanı |
|---|---|---|---|
| Zero-shot | Yalnızca talimat | Hızlı ve ucuzdur | Biçim sapmaları görülebilir |
| One-shot | Tek örnek | Çıktı yapısını gösterir | Tek örnek yanıltıcı olabilir |
| Few-shot | Birkaç örnek | Deseni ve istisnaları öğretir | Daha fazla token tüketir |
| Fine-tuning | Eğitim veri kümesi | Kalıcı uzmanlaşma sağlar | Maliyetli ve zahmetlidir |
Neden üç örnek işe yarayabilir?
İyi seçilmiş üç örnek, görevin farklı köşelerini temsil edebilir. Örneğin müşteri yorumlarını sınıflandırırken bir olumlu, bir olumsuz ve bir kararsız yorum göstermek, modelin olası çıktı uzayını anlamasını kolaylaştırır:
Yorum: Ürün harika, teslimat da hızlıydı.
Etiket: olumlu

Yorum: Paket yırtılmış ve ürün çalışmıyor.
Etiket: olumsuz

Yorum: Fiyat iyi ama malzeme kalitesi ortalama.
Etiket: kararsız

Yorum: Kurulumu kolaydı fakat pil ömrü çok kısa.
Etiket:
Model burada yalnızca kelime eşleştirme yapmaz. Önceki örneklerden beklenen etiket biçimini ve karışık duyguların nasıl değerlendirildiğini çıkarır. Yine de örneklerin sırası veya ifadeleri değiştiğinde sonuç farklılaşabilir.
Python ile dinamik prompt oluşturma
Aşağıdaki kod, örnekleri tek bir şablonda birleştirerek yeni yorum için sınıflandırma promptu üretir:
examples = [
    ('Arayüz çok kullanışlı.', 'olumlu'),
    ('Uygulama sürekli çöküyor.', 'olumsuz'),
    ('Hızlı ama tasarımı eski.', 'kararsız')
]

def build_prompt(new_review):
    parts = ['Yorumları olumlu, olumsuz veya kararsız olarak etiketle.']

    for review, label in examples:
        parts.append(f'Yorum: {review}\nEtiket: {label}')

    parts.append(f'Yorum: {new_review}\nEtiket:')
    return '\n\n'.join(parts)

prompt = build_prompt('Özellikleri güzel fakat abonelik pahalı.')
print(prompt)
Bu yaklaşımda örnekleri koddan bağımsız bir veri kaynağında tutabilir, göreve göre en uygun olanları seçebiliriz. Büyük sistemlerde benzer örnekler gömme vektörleriyle aranarak prompta otomatik biçimde eklenir.
İyi örnek seçmenin kuralları
- Örnekler gerçek kullanıcı girdilerine benzemelidir.
- Her olası sınıf en az bir kez temsil edilmelidir.
- Çıktı biçimi bütün örneklerde tutarlı kalmalıdır.
- Birbirini çürüten veya hatalı etiketlenmiş örneklerden kaçınılmalıdır.
- En alakalı örnekleri yeni girdiye yakın yerleştirmek denenmelidir.
Few-shot prompting sihirli bir değnek değildir. Uzun örnekler token maliyetini artırır; taraflı örnekler ise taraflı cevaplar üretir. Ayrıca prompt içindeki kullanıcı metni talimat gibi algılanabileceğinden güvenilmeyen girdiler açık ayraçlarla sınırlandırılmalıdır.
Sonuç olarak birkaç kaliteli örnek, dev bir modeli görev odaklı bir asistana dönüştürebilir. Başarının sırrı örnek sayısını artırmak değil, karar uzayını açıklayan temsil gücü yüksek örnekleri seçmektir. Modeli uysallaştıran şey kırbaç değil; iyi hazırlanmış üç küçük ipucudur.
Yorumlar