İçindekiler
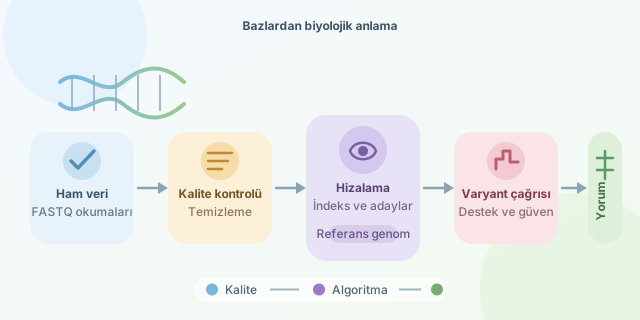
Modern dizileme cihazları tek bir deneyde milyarlarca DNA bazı üretebilir. Ancak cihazdan çıkan A, T, G ve C harfleri tek başına pek anlamlı değildir. Bu devasa yapbozu çözmek; kısa DNA parçalarını referans genoma yerleştirmeyi, farklılıkları bulmayı ve sonuçların güvenilirliğini ölçmeyi gerektirir. İşte biyoinformatik, moleküler biyoloji ile algoritmaların el sıkıştığı noktada devreye girer. ``
Ham veriden genoma uzanan yol
Dizileme sonucu çoğunlukla FASTQ dosyaları elde edilir. Her okuma, yani read, bir DNA dizisiyle birlikte baz kalitesini belirten sayısal değerlere sahiptir. Phred kalite skoru şu ilişkiyle tanımlanır:
\[Q = -10 \log_{10}(P)\]Buradaki $P$, bazın yanlış okunma olasılığıdır. Örneğin $Q=30$, yaklaşık $P=0.001$ hata olasılığına, yani %99,9 doğruluğa karşılık gelir. Analizin ilk aşamasında FastQC gibi araçlarla kalite dağılımı, GC oranı ve adaptör kalıntıları incelenir. Düşük kaliteli uçlar ve adaptörler temizlenmezse sonraki algoritmalar biyolojik olmayan eşleşmeler üretebilir.
Hizalama neden zordur?
İnsan genomu yaklaşık 3,2 milyar baz çifti içerir. Buna karşılık tipik bir kısa okuma yalnızca 100–150 baz uzunluğundadır. Üstelik genomda tekrar eden bölgeler, dizileme hataları, eklemeler ve silinmeler bulunur. Dolayısıyla amaç yalnızca aynı metni aramak değil, küçük farklılıklara izin veren en olası konumu bulmaktır.
İki diziyi karşılaştıran klasik dinamik programlama yaklaşımında genel süre karmaşıklığı $O(nm)$ seviyesindedir. Milyonlarca okumada bu maliyet kabul edilemez. Modern hizalayıcılar bu yüzden genomu indeksler ve yalnızca umut vadeden bölgeleri ayrıntılı olarak değerlendirir.
| Yaklaşım | Temel fikir | Güçlü yanı | Sınırlaması |
|---|---|---|---|
| Needleman–Wunsch | Dizileri uçtan uca hizalar | Küresel hizalamada kesin sonuç | Büyük veride yavaş |
| Smith–Waterman | En iyi yerel bölgeyi arar | Hassas eşleşme | Yüksek hesaplama maliyeti |
| Hash indeksleri | Kısa kelimeleri konumlarla eşler | Hızlı aday bulma | Bellek tüketebilir |
| BWT/FM-index | Sıkıştırılmış genom indeksi kullanır | Hız ve bellek dengesi | Tekrar bölgelerinde belirsizlik |
| De Bruijn grafı | Okumaları $k$-mer bağlantılarıyla birleştirir | Referanssız genom montajı | Hatalara ve $k$ seçimine duyarlı |
BWA ve Bowtie2 gibi araçlar Burrows–Wheeler Dönüşümü ile oluşturulan FM-index yapısından yararlanır. Böylece referans genomun tamamını her okuma için baştan taramak yerine eşleşme aralığı hızlı biçimde daraltılır. Uzun okumalar için Minimap2, dizilerden seçilmiş temsilci parçaları kullanarak aday konumları bulur.
Küçük bir dizi karşılaştırma örneği
Aşağıdaki Python kodu, iki eşit uzunluklu dizinin farklı olduğu konumları belirler. Gerçek hizalayıcıların yaptığı iş çok daha karmaşıktır; ancak varyant bulmanın temel fikrini gösterir:
reference = "ACGTTGCAACGT"
sample = "ACGTCGCAATGT"

variants = []
for position, (ref_base, sample_base) in enumerate(
    zip(reference, sample), start=1
):
    if ref_base != sample_base:
        variants.append({
            "position": position,
            "reference": ref_base,
            "sample": sample_base
        })

for variant in variants:
    print(variant)
Kod, referans ile örneği baz baz karşılaştırır ve değişen konumları kaydeder. Gerçek analizlerde GATK, FreeBayes veya DeepVariant gibi araçlar yalnızca harf farkına bakmaz; okuma derinliği, baz kalitesi ve hizalama güvenini de hesaba katar.
Bir varyantın destek oranı kabaca $f = a/d$ ile ifade edilebilir. Burada $a$ alternatif bazı destekleyen okuma sayısı, $d$ ise toplam kapsama derinliğidir. Örneğin 40 okumanın 20’si farklı bazı taşıyorsa $f=0.5$ olur; bu durum diploid bir genomda heterozigot varyanta işaret edebilir.
Sonuçların biyolojik yorumu
Hizalama sonrasında SAM/BAM dosyaları düzenlenir, yinelenen okumalar işaretlenir ve varyantlar VCF biçiminde raporlanır. Ardından bulunan değişikliklerin genleri, proteinleri veya hastalık riskini etkileyip etkilemediği araştırılır. En hızlı algoritma bile kötü kaliteli veriyle güvenilir biyoloji üretemez. Bu nedenle genom analizi; doğru indeksleme, istatistiksel değerlendirme, kalite kontrolü ve biyolojik yorumun birlikte yürütüldüğü dikkatli bir süreçtir.
Yorumlar