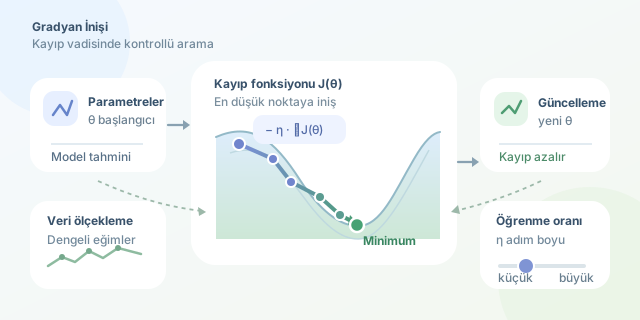
Makine öğrenmesinde model eğitmek, çoğu zaman sisli ve çok boyutlu bir vadide en alçak noktayı aramaya benzer. Bu vadinin yüksekliği kayıp fonksiyonu ile ölçülür: Modelin tahminleri hedeflerden ne kadar uzaksa rakım o kadar artar. Gradyan inişi (Gradient Descent), hangi yöne yürünürse kaybın en hızlı azalacağını hesaplayıp modeli adım adım daha iyi parametrelere taşıyan temel optimizasyon algoritmasıdır.
``
Bir modelin parametrelerini $\theta$ ile, kayıp fonksiyonunu ise $J(\theta)$ ile gösterelim. Amaç basittir: $J(\theta)$ değerini mümkün olduğunca küçültmek. Ancak parametre sayısı yüzlerce, milyonlarca hatta milyarlarca olabilir. Bu nedenle tüm olasılıkları denemek hem pratik dışıdır hem de hesaplama açısından pahalıdır.
Burada gradyan devreye girer. $\nabla J(\theta)$, kaybın her parametreye göre kısmi türevlerinden oluşan bir vektördür. Sezgisel olarak en dik yokuş yukarı yönünü gösterir. Biz aşağı inmek istediğimiz için ters yönünde hareket ederiz:
\[\theta_{t+1} = \theta_t - \eta \nabla J(\theta_t)\]Denklemdeki $\eta$, yani öğrenme oranı, her adımın uzunluğunu belirler. Gradyan pusulaysa öğrenme oranı da adımların boyudur. Küçük bir değer güvenli fakat yavaş ilerler; aşırı büyük bir değer ise vadinin tabanını geçip sürekli sağa sola savrulabilir. Hatta kayıp azalmak yerine büyüyebilir.
| Öğrenme oranı durumu | Eğitim davranışı | Olası sonuç |
|---|---|---|
| Çok küçük $\eta$ | Minik ve temkinli adımlar | Kararlı ama çok yavaş yakınsama |
| Uygun $\eta$ | Kontrollü iniş | Hızlı ve istikrarlı iyileşme |
| Çok büyük $\eta$ | Büyük sıçramalar | Salınım, taşma veya ayrışma |
Çok boyutlu uzayda bu süreç iki boyutlu bir haritadaki yokuştan daha karmaşıktır. Bazı yönlerde eğim dik, bazılarında düzdür. Özellikle uzun ve dar vadilerde gradyan, tabana doğru ilerlemek yerine vadi duvarları arasında zikzak çizebilir. Bu durum, farklı parametre ölçeklerinin eğitimi zorlaştırdığını gösterir. Girdi verisini standardize etmek ve uygun öğrenme oranı seçmek bu yüzden kritik önemdedir.
Gradyan her güncellemede tüm eğitim verisiyle hesaplanabilir; buna Batch Gradient Descent denir. Daha hızlı alternatiflerde veri küçük parçalara ayrılır. Stochastic Gradient Descent (SGD) tek örnekle, mini-batch yaklaşımı ise küçük örnek gruplarıyla güncelleme yapar.
| Yöntem | Gradyan kaynağı | Avantaj | Dezavantaj |
|---|---|---|---|
| Batch GD | Tüm veri kümesi | Kararlı yön tahmini | Büyük veride maliyetli |
| SGD | Tek örnek | Hızlı, yerel minimumlardan sıçrayabilir | Gürültülü güncellemeler |
| Mini-batch GD | Küçük veri grubu | GPU dostu denge | Batch boyutu ayarı gerekir |
Aşağıdaki Python örneği, doğrusal bir modelin ağırlığını ortalama karesel hata ile günceller. Kodda her turda tahmin üretilir, gradyan hesaplanır ve ağırlık kaybı azaltacak yöne çekilir:
import numpy as np

x = np.array([1., 2., 3., 4.])
y = np.array([2., 4., 6., 8.])
w = 0.0
learning_rate = 0.1

for epoch in range(100):
    prediction = w * x
    error = prediction - y
    gradient = (2 / len(x)) * np.sum(error * x)
    w -= learning_rate * gradient

print(f"Öğrenilen ağırlık: {w:.3f}")
Gerçek problemlerde yalnızca sabit bir $\eta$ kullanmak her zaman ideal değildir. Momentum, önceki güncellemelerin yönünü hesaba katarak zikzakları azaltır. AdaGrad, RMSProp ve Adam gibi uyarlamalı yöntemler ise her parametre için etkili adım boyunu dinamik biçimde düzenler. Yine de sihirli bir ayar yoktur: eğitim ve doğrulama kayıplarını izlemek, öğrenme oranı taraması yapmak ve erken durdurma kullanmak güvenilir bir optimizasyon reçetesidir.
Özetle gradyan inişi, türevin matematiksel bilgisini pratik bir arama stratejisine dönüştürür. Doğru adım büyüklüğü, uygun veri ölçekleme ve doğru varyant seçildiğinde, devasa parametre uzaylarında bile modelin kayıp vadisinin tabanına kararlı biçimde yaklaşmasını sağlar.
Yorumlar