İçindekiler
Bir sosyal ağdaki arkadaşlıkları, şehirler arasındaki yolları veya internet üzerindeki bağlantıları bilgisayarda nasıl saklarız? Matematikte birkaç nokta ve çizgiyle gösterilen graflar, belleğe yerleştirilirken biraz daha seçici olmamızı ister. En yaygın iki seçenek olan komşuluk matrisi ve komşuluk listesi, aynı grafı temsil etse de bellek tüketimi ve işlem performansı bakımından oldukça farklı davranır.
``
Önce grafın temelini kuralım
Bir graf, $G=(V,E)$ biçiminde tanımlanır. Burada $V$ düğümler, $E$ ise düğümler arasındaki kenarlardır. Düğüm sayısını $\vert V\vert =n$, kenar sayısını da $\vert E\vert =m$ ile gösterelim.
Bir grafın sahip olabileceği kenar sayısı, yönsüz ve öz döngüsüz durumda en fazla:
\[m_{max}=\frac{n(n-1)}{2}\]olur. Eğer $m$, bu üst sınıra yakınsa grafa yoğun graf; kenar sayısı düğüm sayısına yakınsa seyrek graf denir. Temsil yöntemi seçilirken asıl belirleyici çoğu zaman bu yoğunluktur.
Komşuluk matrisi
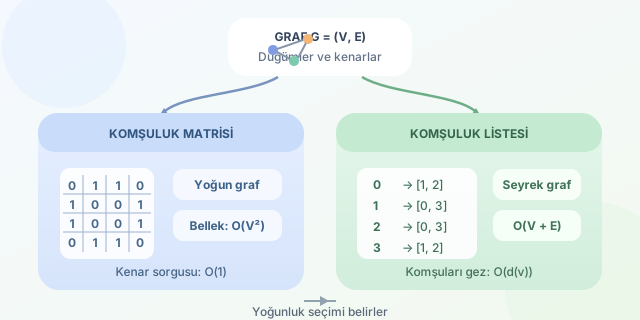
Komşuluk matrisi, $n \times n$ boyutunda iki boyutlu bir tablodur. matris[i][j] değeri, i ile j arasında kenar varsa 1, yoksa 0 olur. Ağırlıklı graflarda bu hücreye kenarın ağırlığı yazılabilir.
# Dört düğümlü yönsüz bir grafın komşuluk matrisi
matris = [
    [0, 1, 1, 0],
    [1, 0, 0, 1],
    [1, 0, 0, 1],
    [0, 1, 1, 0]
]

# 0 ve 2 arasında doğrudan kenar var mı?
print(matris[0][2] == 1)
Bu yöntemin yıldız özelliği, iki düğüm arasında kenar bulunup bulunmadığını $O(1)$ zamanda söylemesidir. Ancak grafın yalnızca birkaç kenarı olsa bile bütün hücreler ayrılır. Dolayısıyla bellek karmaşıklığı her durumda $O(V^2)$ olur.
Bir düğümün tüm komşularını bulmak için ilgili satırın tamamı gezilir. Bu işlem $O(V)$ zaman alır. Matris, özellikle yoğun graflarda ve sık kenar sorgusu yapılan uygulamalarda güçlüdür.
Komşuluk listesi
Komşuluk listesinde her düğüm için yalnızca bağlantılı olduğu düğümler tutulur. Boş bağlantılar bellekte yer kaplamaz; yani kullanılmayan koltuklara bilet kesilmez.
# Aynı grafın komşuluk listesi gösterimi
liste = {
    0: [1, 2],
    1: [0, 3],
    2: [0, 3],
    3: [1, 2]
}

# 0 düğümünün komşularını dolaş
for komsu in liste[0]:
    print(komsu)
Bu yapının bellek maliyeti $O(V+E)$ düzeyindedir. Bir düğümün komşularını dolaşmak, düğümün derecesi $d(v)$ olmak üzere $O(d(v))$ sürer. Buna karşılık belirli iki düğümün komşu olup olmadığını aramak, kullanılan liste yapısına göre $O(d(v))$ zaman alabilir. Komşular bir set içinde saklanırsa ortalama sorgu süresi $O(1)$ seviyesine indirilebilir; fakat ek bellek maliyeti oluşur.
Hızlı karşılaştırma
| Özellik | Komşuluk matrisi | Komşuluk listesi |
|---|---|---|
| Bellek | $O(V^2)$ | $O(V+E)$ |
| Kenar sorgusu | $O(1)$ | $O(d(v))$ |
| Komşuları gezme | $O(V)$ | $O(d(v))$ |
| Kenar ekleme | $O(1)$ | Genellikle $O(1)$ |
| Uygun graf türü | Yoğun | Seyrek |
| Uygulama kolaylığı | Çok basit | Biraz daha esnek |
Hangisini seçmeliyiz?
Grafınızda binlerce düğüm fakat az sayıda bağlantı varsa komşuluk listesi açık ara daha ekonomiktir. Örneğin yol ağları, web bağlantıları ve sosyal ağların büyük bölümü seyrektir. Bu yapılarda BFS ve DFS gibi algoritmalar listeyle $O(V+E)$ zamanda çalışır; matris kullanılırsa süre $O(V^2)$ seviyesine çıkabilir.
Düğüm sayısı küçükse, graf yoğunsa veya uygulama sürekli “Bu iki düğüm bağlı mı?” diye soruyorsa komşuluk matrisi daha pratik olabilir. Floyd–Warshall gibi matris tabanlı algoritmalar da doğal olarak bu gösterimle uyumludur.
Kısacası evrensel bir kazanan yoktur: matris sorgu hızını, liste ise bellek verimliliğini öne çıkarır. Doğru seçim, grafın yoğunluğuna ve en sık yapılacak işleme bağlıdır.
Yorumlar