İçindekiler
Komut satırında her metin problemi bir çivi gibi görünüyorsa, elimizdeki ilk komutu çekiç olarak kullanmak cazip gelir. Böylece grep ile hesap yapmaya, sed ile sütun toplamaya veya awk ile yalnızca bir kelime aramaya çalışırız. Sonuç bazen çalışır; fakat okunabilirlik, taşınabilirlik ve bakım kolaylığı sessizce pencereden kaçar.
``
Üç aracın temel zihinsel modeli
Bu araçların hepsi standart girdiyi okuyabilir ve boru hatlarında kullanılabilir; ancak metne farklı gözlüklerle bakarlar.
- grep, satırların belirli bir desene uyup uymadığıyla ilgilenir.
- sed, metni satır satır dönüştüren bir akış düzenleyicisidir.
- awk, kayıtları alanlara ayırıp koşul, değişken ve aritmetik kullanabilen küçük bir programlama dilidir.
Bir dosyada $n$ satır, her satırda ortalama $m$ karakter varsa basit tarama maliyeti kabaca $O(nm)$ olur. Araç seçiminin asıl farkı çoğunlukla teorik karmaşıklık değil, aynı işi ifade etmek için gereken zihinsel ve sözdizimsel karmaşıklıktır.
| Görev | Doğru başlangıç aracı | Temel güç |
|---|---|---|
| Eşleşen satırları bulmak | grep |
Düzenli ifadeyle filtreleme |
| Metni değiştirmek veya silmek | sed |
Akış üzerinde dönüşüm |
| Sütunları işlemek ve hesaplamak | awk |
Alanlar, koşullar ve aritmetik |
grep ile tornavida kullanmak
grep yalnızca eşleşen satırları seçmek için mükemmeldir:
grep -i "error" app.log
Bu komut, büyük-küçük harfi önemsemeden error içeren satırları getirir. Fakat ikinci sütundaki değerleri toplamak istiyorsak grep, görevi tek başına doğal biçimde ifade edemez. Karmaşık grep, cut, paste ve bc zincirleri kurulabilir; ancak bu, market alışverişine forkliftle gitmeye benzer.
Doğal çözüm awk kullanmaktır:
awk '{ toplam += $2 } END { print toplam }' satis.txt
Burada her satır bir kayıt, boşluklarla ayrılmış parçalar ise alan kabul edilir. $2 ikinci alanı, END ise bütün kayıtlar işlendikten sonraki aşamayı temsil eder.
sed ile muhasebe yapmaya çalışmak
sed, değiştirme işlemlerinde parlar:
sed 's/http:/https:/g' adresler.txt
Komut, her satırdaki tüm http: ifadelerini https: ile değiştirir. Buna karşılık sayısal karşılaştırma, toplam veya ortalama gerektiğinde sed komutları hızla anlaşılmaz hâle gelir.
Örneğin üçüncü sütunu 100’den büyük kayıtları seçmek için doğru yaklaşım şudur:
awk '$3 > 100 { print $1, $3 }' veriler.txt
Ortalama hesaplamak da doğrudandır. Değerlerin toplamı $S$, kayıt sayısı $N$ ise ortalama
\[\bar{x} = \frac{S}{N}\]olur:
awk '{ s += $3; n++ } END { if (n) print s / n }' veriler.txt
awk ile basit aramayı büyütmek
awk '/hata/' app.log geçerli bir komuttur; fakat yalnızca eşleşen satırları istiyorsak niyetimizi grep 'hata' app.log daha açık anlatır. awk, alan seçimi veya ek mantık devreye girdiğinde anlam kazanır:
awk '$2 == "ERROR" && $4 >= 500 { print $1, $4 }' app.log
Bu örnek hem alan karşılaştırır hem sayısal koşul uygular. Yani awk burada gerçekten maaşını hak eder.
Araçlar rakip değil, ekip arkadaşıdır
Tek bir komuta bütün işi yüklemek zorunda değiliz. Önce ilgili satırları filtreleyip sonra metni dönüştürebiliriz:
grep '^WARN' app.log | sed 's/^WARN/UYARI/'
Yine de gereksiz süreçlerden kaçınmak gerekir. Aynı işlem tek ve anlaşılır bir awk programıyla yapılabiliyorsa uzun boru hattı kurmak hata ayıklamayı zorlaştırabilir.
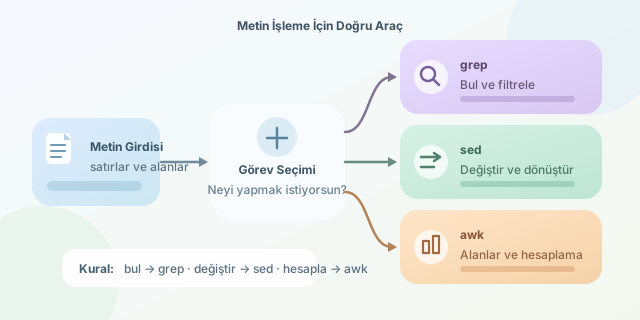
Pratik karar kuralı basittir: Buluyorsan grep, değiştiriyorsan sed, alanlar üzerinde düşünüyor veya hesaplıyorsan awk. Görev büyüdükçe kabuk komutlarını zorlamak yerine Python gibi genel amaçlı bir dile geçmek de yenilgi değil, doğru mühendislik kararıdır.
Yorumlar