İçindekiler
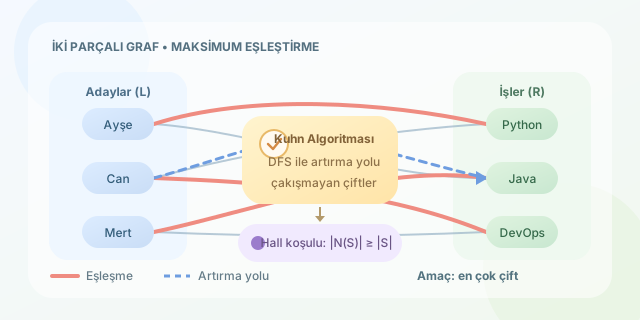
Bir tarafta adaylar, diğer tarafta işler olduğunu düşünün. Her aday yalnızca belirli işleri yapabiliyor ve herkes en fazla bir işle eşleştirilebiliyor. Amaç, mümkün olduğunca çok adayı uygun bir işe yerleştirmek. Romantik adıyla Evlenme Problemi, gerçekte iş dağıtımından üniversite tercih sistemlerine kadar pek çok yerde karşımıza çıkan klasik bir graf problemidir.
``
İki parçalı graf nedir?
Bir grafın düğümleri, kendi içlerinde bağlantı bulunmayan iki ayrı kümeye ayrılabiliyorsa bu grafa iki parçalı graf denir. Grafı
\[G=(L \cup R, E)\]şeklinde gösterebiliriz. Burada $L$ sol grubu, $R$ sağ grubu, $E$ ise iki grup arasındaki uygunluk bağlantılarını temsil eder. Örneğin $L$ adaylar, $R$ işler olabilir.
Bir eşleştirme, hiçbir düğümün birden fazla seçilmiş kenarda yer almadığı kenarlar kümesidir. Aradığımız maksimum eşleştirme, mümkün olan en fazla kenarı içeren eşleştirmedir.
| Kavram | Anlamı | Örnek |
|---|---|---|
| Kenar | İki öğenin uyumlu olması | Ayşe, Python işini yapabilir |
| Eşleştirme | Çakışmayan bağlantılar | Ayşe–Python, Can–Java |
| Maksimum eşleştirme | En çok çifti oluşturan sonuç | 4 adaydan 4’ünü yerleştirmek |
| Mükemmel eşleştirme | Her düğümün eşleşmesi | Kimse açıkta kalmaz |
Hall Evlenme Teoremi
Teorinin kalbinde Hall Teoremi bulunur. Sol gruptaki herhangi bir $S$ alt kümesinin erişebildiği sağ düğümler $N(S)$ ile gösterilsin. Sol taraftaki herkesin eşleşebilmesi için şu koşul gereklidir ve yeterlidir:
\[\vert N(S)\vert \geq \vert S\vert\]Yani üç adayın toplamda yalnızca iki uygun işe erişimi varsa üçünü birden yerleştirmek imkânsızdır. Sandalye kapmaca oyununda üç kişinin önüne iki sandalye koymak gibi: algoritma çok zeki olabilir ama yeni sandalye üretemez.
Artırma yolu yaklaşımı
Kuhn algoritması her sol düğüm için uygun bir sağ düğüm arar. İstenen sağ düğüm boşsa eşleşme kurulur. Doluysa, mevcut eşleşmenin başka bir yere taşınıp taşınamayacağı derinlik öncelikli arama ile kontrol edilir. Böylece eşleşme sayısını bir artıran artırma yolu bulunabilir.
def maksimum_eslesme(graf):
    # sag_eslesme[is] = o işe yerleştirilen aday
    sag_eslesme = {}

    def yer_bul(aday, ziyaret):
        for is_adi in graf.get(aday, []):
            if is_adi in ziyaret:
                continue

            ziyaret.add(is_adi)
            mevcut_aday = sag_eslesme.get(is_adi)

            # İş boşsa veya mevcut aday başka işe taşınabiliyorsa
            if mevcut_aday is None or yer_bul(mevcut_aday, ziyaret):
                sag_eslesme[is_adi] = aday
                return True

        return False

    for aday in graf:
        yer_bul(aday, set())

    return {aday: is_adi for is_adi, aday in sag_eslesme.items()}


graf = {
    "Ayşe": ["Python", "Veri"],
    "Can": ["Python", "Java"],
    "Ece": ["Veri"],
    "Mert": ["Java", "DevOps"]
}

print(maksimum_eslesme(graf))
Buradaki ziyaret kümesi, aynı arama sırasında bir işe tekrar gidilmesini önleyerek döngüleri ve gereksiz denemeleri engeller. Her aday için yeni bir küme oluşturulur; çünkü sonraki aday alternatif yolları yeniden değerlendirebilmelidir.
Karmaşıklık ve doğru algoritma seçimi
Bu DFS tabanlı çözümün zaman karmaşıklığı yaklaşık olarak
\[O(\vert L\vert \cdot \vert E\vert )\]olur. Küçük ve orta ölçekli problemler için anlaşılır ve yeterince hızlıdır.
| Yöntem | Yaklaşık karmaşıklık | Kullanım alanı |
|---|---|---|
| Kuhn | $O(VE)$ | Eğitim, küçük ve orta graflar |
| Hopcroft–Karp | $O(E\sqrt{V})$ | Büyük iki parçalı graflar |
| Macar algoritması | $O(n^3)$ | Ağırlıklı, maliyetli atamalar |
Önemli ayrım şudur: Kuhn algoritması eşleşen çift sayısını büyütür; tercih puanlarının toplamını optimize etmez. Her bağlantının puanı veya maliyeti varsa ağırlıklı eşleştirme algoritmaları kullanılmalıdır. Böylece “en fazla kaç çift?” ile “toplamda en iyi çiftler hangileri?” sorularını birbirine karıştırmamış oluruz.
Yorumlar