İçindekiler
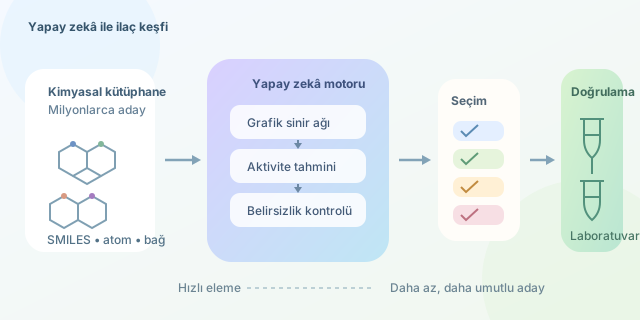
Yeni bir ilaç geliştirmek, milyarlarca olası molekül arasından doğru anahtarı bulmaya benzer. Geleneksel yaklaşımda araştırmacılar çok sayıda bileşiği sentezleyip laboratuvarda test eder. Yapay zekâ ise henüz deney tüpüne dokunmadan hangi moleküllerin umut vadettiğini tahmin ederek arama alanını küçültür. Böylece laboratuvar ortadan kalkmaz; yalnızca daha seçici, hızlı ve ekonomik kullanılır. ``
Bilgisayar bir molekülü nasıl görür?
Bir kimyager moleküle atomlar, bağlar ve fonksiyonel gruplar üzerinden bakar. Bilgisayarın çalışabilmesi için bunların sayısal bir temsile dönüştürülmesi gerekir. En yaygın gösterimlerden biri, moleküler yapıyı metin biçiminde ifade eden SMILES dizileridir. Örneğin etanol CCO olarak yazılabilir.
Moleküller ayrıca birer grafik olarak modellenebilir: atomlar düğüm, kimyasal bağlar ise kenardır. Grafik sinir ağları, komşu atomlardan bilgi toplayarak molekülün çözünürlük, toksisite veya hedef proteine bağlanma eğilimi gibi özelliklerini öğrenebilir.
Bir modelin temel amacı yaklaşık olarak şu fonksiyonu öğrenmektir:
\[f(\text{molekül}) \rightarrow \text{aktivite, toksisite, çözünürlük, bağlanma gücü}\]Tahmin edilen değer ile deneysel sonuç arasındaki fark, örneğin ortalama karesel hata kullanılarak ölçülebilir:
\[MSE = \frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2\]Model, bu hatayı azaltacak şekilde eğitilir. Ancak düşük hata her zaman yeni kimyasal yapılarda başarılı olunacağı anlamına gelmez; eğitim verisinin çeşitliliği kritik önemdedir.
Sanal tarama nasıl ilerler?
| Yaklaşım | Temel fikir | Güçlü yanı | Sınırlaması |
|---|---|---|---|
| QSAR | Yapısal özelliklerden biyolojik aktivite tahmini | Çok sayıda molekülü hızlı tarar | Kaliteli etiketli veri ister |
| Moleküler kenetlenme | Molekülü proteinin bağlanma cebine yerleştirir | Üç boyutlu etkileşimleri inceler | Skorlama fonksiyonları yaklaşık sonuç verir |
| Grafik sinir ağı | Atom ve bağ ilişkilerini öğrenir | Özellikleri otomatik çıkarabilir | Yüksek veri ve hesaplama ihtiyacı doğurabilir |
| Üretici model | Yeni molekül tasarımları önerir | Bilinen katalogla sınırlı değildir | Sentezlenmesi imkânsız yapılar üretebilir |
Tipik süreçte önce hastalıkla ilişkili bir protein hedefi seçilir. Ardından milyonlarca molekül, hızlı tahmin modelleriyle elenir. Kalan adaylar kenetlenme ve moleküler dinamik yöntemleriyle incelenir. Son aşamada aktivite kadar ADMET özellikleri de değerlendirilir: emilim, dağılım, metabolizma, atılım ve toksisite.
Python ile küçük bir moleküler ön eleme
Aşağıdaki örnek, RDKit kullanarak moleküllerin molekül ağırlığını ve yağ-severliğini belirten LogP değerini hesaplar. Belirlenen sınırları aşan adaylar elenir:
from rdkit import Chem
from rdkit.Chem import Descriptors

adaylar = ['CCO', 'CC(=O)OC1=CC=CC=C1C(=O)O', 'CCCCCCCCCCCC']

for smiles in adaylar:
    molekul = Chem.MolFromSmiles(smiles)
    if molekul is None:
        continue

    agirlik = Descriptors.MolWt(molekul)
    logp = Descriptors.MolLogP(molekul)
    uygun = agirlik < 500 and logp < 5

    print(smiles, round(agirlik, 2), round(logp, 2), uygun)
Bu kod ilaç keşfetmez; yalnızca basit bir filtre uygular. Gerçek projelerde parmak izi vektörleri, deneysel aktivite verileri ve makine öğrenmesi modelleri birlikte kullanılır. Ayrıca aynı proteine güçlü bağlanan iki molekülden biri zehirli, kararsız veya vücutta hızla parçalanan bir aday olabilir.
Yapay zekânın freni: belirsizlik
Modelin yalnızca tahmin vermesi yetmez; tahminine ne kadar güvendiğini de belirtmesi gerekir. Eğitim kümesine hiç benzemeyen bir molekül için yüksek güven bildiren sistem tehlikelidir. Bu nedenle ansambl modelleri, olasılıksal yöntemler ve uygulanabilirlik alanı kontrolleri kullanılır.
Sonuç olarak yapay zekâ, kimyagerin yerine geçen sihirli bir laboratuvar değildir. Daha çok dev bir kimyasal kütüphanede fener tutan hızlı bir araştırma asistanıdır. En umut verici adayları öne çıkarır, başarısız deneyleri azaltır ve hipotez üretir. Fakat güvenlik ve etkinlik iddialarının doğrulanması için sentez, hücre deneyleri, hayvan çalışmaları ve klinik araştırmalar hâlâ vazgeçilmezdir.
Yorumlar