İçindekiler
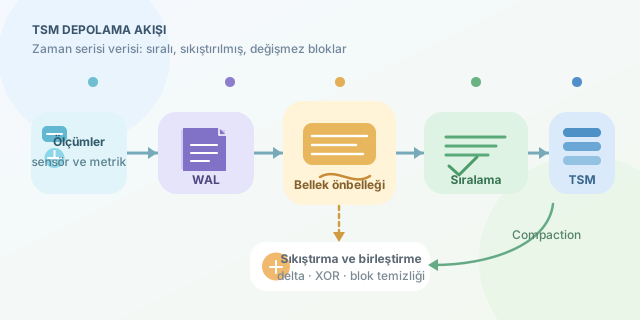
Bir sıcaklık sensörü düşünün: Her saniye ölçüm gönderiyor. Şimdi buna binlerce sensör, sunucu metriği ve uygulama olayı ekleyin. Ortaya sürekli büyüyen bir veri nehri çıkar. InfluxDB’nin TSM, yani Time-Structured Merge Tree motoru, bu nehri klasik veritabanları gibi satır satır saklamak yerine zamanın düzeninden yararlanarak sıkıştırır ve diske verimli biçimde aktarır.
``
Neden klasik depolama yaklaşımı yetmiyor?
Zaman serisi verileri çoğunlukla ekleme ağırlıklıdır. Geçmişteki CPU ölçümünü sürekli güncellemez, yeni zaman damgasıyla yeni bir değer eklersiniz. Ayrıca sorgular genellikle belirli bir serinin zaman aralığını ister:
SELECT mean(usage)
FROM cpu
WHERE time >= now() - 1h
GROUP BY time(1m)
Genel amaçlı bir B-tree motoru her kaydı ayrı anahtarlarla yönetirken TSM, aynı seriye ve benzer zaman aralığına ait değerleri bloklar hâlinde tutar.
| Özellik | Genel amaçlı motor | TSM yaklaşımı |
|---|---|---|
| Yazma modeli | Rastgele ekleme/güncelleme | Sıralı ve toplu yazma |
| Temel erişim | Anahtar veya satır | Seri ve zaman aralığı |
| Sıkıştırma | Genel amaçlı | Veri tipine özel |
| Disk işlemi | Daha rastgele olabilir | Büyük, sıralı bloklar |
| Tipik kullanım | İş kayıtları | Metrikler ve sensörler |
Yazma hattı: WAL, cache ve TSM dosyaları
InfluxDB’ye bir nokta ulaştığında doğrudan kalıcı TSM dosyasının ortasına yazılmaz. Önce Write-Ahead Log (WAL) üzerine eklenir. Böylece sistem çökerse onaylanmış veriler yeniden oynatılabilir. Aynı veri bellekteki cache’e de yerleşir; cache sorgulara güncel sonuç verir ve yazıları biriktirir.
Cache belirli bir eşiğe ulaştığında snapshot alınır. Noktalar seri ve zamana göre sıralanır, sıkıştırılmış bloklara dönüştürülür ve değişmez bir TSM dosyasına yazılır. Değişmezlik önemlidir: Motor eski dosyayı sürekli yamamak yerine yenisini üretir. Bu yaklaşım rastgele disk erişimini azaltır.
Basitleştirilmiş akış şöyledir:
Line Protocol -> WAL -> Bellek Cache'i
                         |
                         v
                  Snapshot ve sıralama
                         |
                         v
                  Sıkıştırılmış TSM
Sıkıştırmanın matematiksel numarası
Zaman damgaları çoğu zaman eşit aralıklıdır. Ham değerleri saklamak yerine fark alınabilir:
\[\Delta_i = t_i - t_{i-1}\]Ölçüm her saniye geliyorsa farklar sürekli 1000 milisaniyedir. Daha da ileri gidilip farkların farkı hesaplanır:
\[\Delta\Delta_i = \Delta_i - \Delta_{i-1}\]Düzenli akışta sonuç çoğunlukla sıfırdır ve çok az bit kullanılarak kodlanabilir. Float değerlerde ardışık sayıların bit desenleri XOR ile karşılaştırılabilir; benzer değerlerin ortak bitleri tekrar yazılmaz. Tamsayılar, boolean değerler ve metinler için de veri tipine uygun kodlama yöntemleri kullanılır.
Örneğin sensör verisi Line Protocol ile şöyle gönderilebilir:
import requests

point = 'temperature,room=lab value=23.7 1735689600000000000'
requests.post(
    'http://localhost:8086/api/v2/write?org=demo&bucket=sensors&precision=ns',
    data=point,
    headers={'Authorization': 'Token TOKEN'}
)
Burada room=lab etiketi seriyi tanımlar, value alan değeri taşır ve sondaki sayı nanosaniye hassasiyetli zaman damgasıdır. Yüksek kardinaliteli etiketlerin çok fazla seri oluşturabileceği unutulmamalıdır.
Compaction neden gerekli?
Sürekli snapshot üretmek çok sayıda küçük TSM dosyası oluşturur. Compaction, bu dosyaları arka planda birleştirir, blokları yeniden sıralar ve daha iyi sıkıştırır. Silme işlemleri ise çoğunlukla veriyi anında fiziksel olarak kazımak yerine tombstone kayıtları oluşturur; sonraki compaction geçersiz aralıkları temizler.
TSM’nin başarısı tek bir sihirli algoritmadan değil; WAL ile dayanıklılık, cache ile yazma tamponlama, tipe özel sıkıştırma, değişmez dosyalar ve compaction iş birliğinden gelir. Kısacası TSM, zaman serisi verisine sıradan satırlar olarak değil, ritmi tahmin edilebilen bir sinyal olarak davranır. Milyonlarca ölçümün makul disk alanına ve yüksek yazma hızına dönüşmesinin sırrı da tam olarak budur.
Yorumlar