İçindekiler
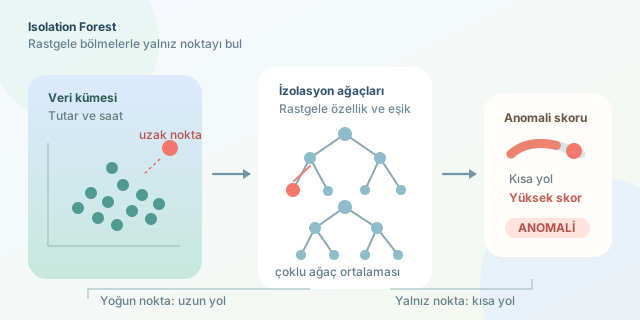
Bir veri kümesinde aykırı değer ararken çoğu yöntem önce “normal” davranışın nasıl göründüğünü öğrenmeye çalışır. Isolation Forest ise meseleyi tersinden ele alır: Normal değerlerin ayrıntılı profilini çıkarmak yerine, rastgele bölmelerle hangi gözlemlerin daha çabuk yalnız kaldığına bakar. Çünkü kalabalıktan uzak duran bir veri noktasını izole etmek, mahallenin ortasında yaşayan bir noktayı izole etmekten genellikle daha kolaydır.
``
Temel fikir: Anomali neden çabuk izole edilir?
Elimizde işlem tutarı ve işlem saati gibi özelliklerden oluşan bir veri kümesi bulunduğunu düşünelim. Noktaların çoğu birbirine yakınken çok yüksek tutarlı, gece yarısı yapılmış tek bir işlem uzak bir bölgede kalabilir. Isolation Forest, rastgele bir özellik seçer ve bu özelliğin minimum ile maksimum değerleri arasında rastgele bir bölme üretir.
Bu işlem ağaç boyunca tekrarlandığında aykırı nokta birkaç bölmeden sonra tek başına kalabilir. Normal bir noktanın ayrılması içinse kalabalık komşuluğun tekrar tekrar parçalanması gerekir. Bir gözlemin kökten yaprağa kadar geçtiği kenar sayısına yol uzunluğu denir ve $h(x)$ ile gösterilir.
| Gözlem türü | Ortalama yol uzunluğu | Beklenen sonuç |
|---|---|---|
| Yoğun bölgede normal nokta | Uzun | Düşük anomali skoru |
| Sınırda bulunan nokta | Orta | Şüpheli |
| Uzak ve seyrek nokta | Kısa | Yüksek anomali skoru |
Tek bir rastgele ağaç yanıltıcı olabilir. Bu nedenle algoritma birçok izolasyon ağacı oluşturur ve sonuçların ortalamasını alır. “Forest” kelimesinin hakkını veren kısım da tam olarak budur.
Anomali skoru nasıl hesaplanır?
Bir $x$ gözleminin skorunda, ağaçlar üzerindeki ortalama yol uzunluğu $E[h(x)]$ kullanılır:
\[s(x,n)=2^{-\frac{E[h(x)]}{c(n)}}\]Buradaki $n$ örnek sayısını, $c(n)$ ise başarısız bir ikili arama ağacındaki ortalama yol uzunluğunu temsil eden normalleştirme katsayısını belirtir:
\[c(n)=2H(n-1)-\frac{2(n-1)}{n}\]$H(i)$ harmonik sayıdır ve yaklaşık olarak $H(i)\approx \ln(i)+\gamma$ biçiminde hesaplanabilir. Skor 1’e yaklaştıkça gözlem daha anormal, 0,5 civarında kaldıkça daha sıradan kabul edilir. Böylece farklı veri büyüklüklerinden elde edilen yol uzunlukları karşılaştırılabilir hâle gelir.
Python ile küçük bir anomali avı
Scikit-learn içindeki IsolationForest sınıfı, yöntemi birkaç satırda uygulamamızı sağlar:
import pandas as pd
from sklearn.ensemble import IsolationForest

veri = pd.DataFrame({
    "tutar": [42, 48, 51, 46, 49, 1200, 44, 53],
    "saat":  [13, 14, 12, 15, 13, 3, 16, 12]
})

model = IsolationForest(
    n_estimators=200,
    contamination=0.125,
    random_state=42
)

model.fit(veri)
veri["tahmin"] = model.predict(veri)
veri["anomali_skoru"] = -model.score_samples(veri)

print(veri.sort_values("anomali_skoru", ascending=False))
n_estimators, ormandaki ağaç sayısını belirler. Daha fazla ağaç genellikle daha kararlı sonuç üretir ancak hesaplama maliyetini artırır. contamination, veride beklenen anomali oranıdır. predict normal gözlemler için 1, anomaliler için -1 döndürür. score_samples sonucunun işaretini ters çevirerek büyük değerin daha şüpheli olduğu, okunması kolay bir skor elde ediyoruz.
Neden tercih edilir?
| Yaklaşım | Normal dağılım varsayımı | Büyük veride hız | Yüksek boyuta uygunluk |
|---|---|---|---|
| Z-skoru | Genellikle gerekli | Yüksek | Düşük |
| Kümeleme tabanlı yöntemler | Gerekli değil | Değişken | Orta |
| Isolation Forest | Gerekli değil | Yüksek | İyi |
Isolation Forest’ın eğitim maliyeti örnekleme sayesinde yaklaşık $O(t\,\psi\log\psi)$ düzeyindedir. Burada $t$ ağaç sayısını, $\psi$ ise her ağaç için kullanılan örnek büyüklüğünü gösterir. Bu yapı, milyonlarca satırın bulunduğu dolandırıcılık, sensör arızası ve sistem günlüğü senaryolarında yöntemi cazip kılar.
Yine de algoritma “neden anomali?” sorusunu tek başına açıklamaz. Kategorik değişkenler uygun biçimde kodlanmalı, özellik ölçekleri ve veri sızıntısı kontrol edilmeli, contamination iş bilgisiyle seçilmelidir. Kısacası Isolation Forest hızlı bir bekçidir; alarmı iyi çalar, fakat olay yerindeki son kararı yine alan bilgisi verir.
Yorumlar