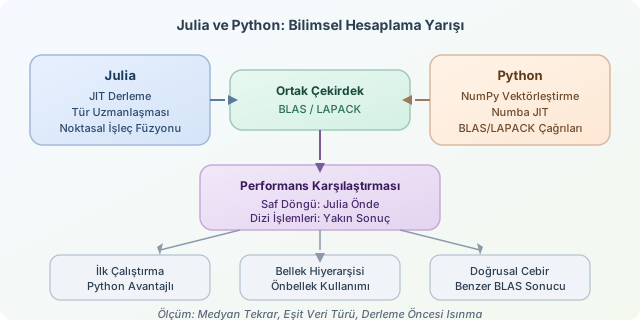
Bilimsel hesaplamada hız yalnızca “kod ne kadar çabuk bitti?” sorusu değildir; algoritma, bellek erişimi, derleyici ve kullanılan kütüphanelerin ortak sonucudur. Julia, MATLAB benzeri okunabilir sözdizimini derlenen bir dilin performans hedefiyle birleştirirken; Python çoğunlukla NumPy, SciPy ve Numba gibi araçlarla yüksek performansa ulaşır. Doğru karşılaştırma, saf döngüler ile vektörleştirilmiş işlemleri birbirinden ayırmayı gerektirir.
``
Bir sayısal algoritmanın çalışma süresini kabaca $T(n)$ ile gösterelim. İki yoğun $n \times n$ matrisin çarpımı için teorik maliyet klasik yaklaşımda $O(n^3)$ tür. Ancak gerçek sürede bellek hiyerarşisi, önbellek kullanımı ve BLAS kütüphanesi belirleyicidir. Bu nedenle aynı algoritmanın iki dildeki farkı, özellikle büyük boyutlarda, çoğu zaman dilin kendisinden çok çağrılan sayısal çekirdekte ortaya çıkar.
Julia’nın temel kozu JIT (just-in-time) derleme ve tür uzmanlaşmasıdır. Bir fonksiyon ilk kez belirli veri türleriyle çağrıldığında makine koduna derlenir. Böylece Float64 diziler üzerinde yazılmış sıradan bir for döngüsü, çoğu senaryoda C veya Fortran’a yakın makine kodu üretebilir. Bunun bedeli ise ilk çağrıdaki derleme gecikmesidir; küçük ve tek seferlik işlerde bu süre yanıltıcı olabilir.
| Senaryo | Julia yaklaşımı | Python yaklaşımı | Beklenen sonuç |
|---|---|---|---|
| Saf sayısal döngü | JIT ile hızlı | Saf CPython’da yavaş | Julia belirgin önde |
| Dizi işlemleri | Yerleşik yayınlama (.) |
NumPy vektörleştirmesi | Genellikle yakın |
| Doğrusal cebir | BLAS/LAPACK çağrıları | NumPy/SciPy üzerinden BLAS | Çoğunlukla benzer |
| İlk çalıştırma | Derleme maliyeti var | Genellikle daha hızlı başlar | Python avantajlı olabilir |
Örneğin aşağıdaki çekirdek, her eleman için $f(x)=\sin(x)^2+\cos(x)^2$ hesaplar. Matematiksel olarak sonuç $1$ olsa da örnek, döngü maliyetini gözlemlemek için kullanışlıdır. Julia’da noktasal işleç kullanmak, ara diziler üretmeden füzyon yapmaya yardımcı olur.
using BenchmarkTools

function identity_kernel!(out, x)
    @inbounds for i in eachindex(x)
        out[i] = sin(x[i])^2 + cos(x[i])^2
    end
    return out
end

x = rand(10^7)
out = similar(x)
identity_kernel!(out, x) # Derleme maliyetini ölçüm dışına alır
@btime identity_kernel!($out, $x)
Buradaki @inbounds, indeks sınırı kontrollerini kaldırarak performansı artırabilir; fakat yanlış indeks mantığında güvenliği azaltır. @btime ise değişkenleri $ ile çağrı kapsamına aktarır ve gereksiz küresel değişken maliyetlerini önler.
Python tarafında aynı döngüyü saf for ile yazmak adil bir “en iyi Python” testi değildir. NumPy, işlemleri C düzeyindeki döngülere taşır; Numba ise Python benzeri döngüleri makine koduna derleyebilir.
import numpy as np
from numba import njit

@njit
def identity_kernel(x):
    out = np.empty_like(x)
    for i in range(x.size):
        out[i] = np.sin(x[i])**2 + np.cos(x[i])**2
    return out

x = np.random.rand(10_000_000)
identity_kernel(x)  # Numba derlemesini önceden tetikler
Sağlıklı benchmark için eşit veri türü kullanın, ilk Julia/Numba çağrısını ayrı ölçün, sonuçların eşdeğerliğini kontrol edin ve birden çok tekrarın medyanını alın. Ayrıca A * B gibi matris çarpımlarında iki ekosistem de aynı ya da benzer optimize BLAS sürümünü kullanıyorsa dramatik fark beklemeyin. Julia’nın güçlü olduğu alan, okunabilir döngülerle karmaşık özel algoritmalar yazarken “önce vektörleştir, yoksa yavaş olur” baskısını azaltmasıdır. Python ise dev ekosistemi, olgun araçları ve NumPy/Numba kombinasyonuyla hâlâ son derece güçlü bir bilimsel hesaplama seçeneğidir.
Yorumlar