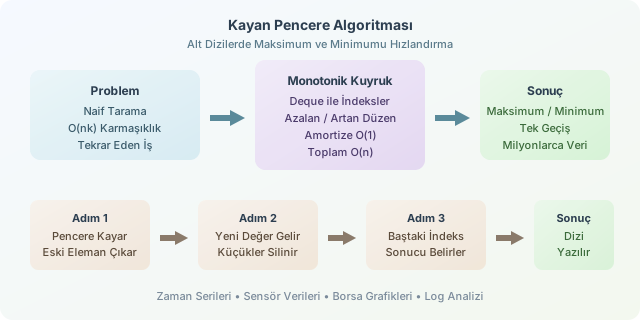
Bir dizide ardışık $k$ elemanlık her grubun maksimumunu veya minimumunu bulmak, ilk bakışta basit görünür: Her konumda pencereyi tara, sonucu yaz. Ancak veri büyüdüğünde bu yaklaşım bir performans tuzağına dönüşür. Kayan Pencere (Sliding Window), pencerenin her adımda yalnızca bir eleman kaybettiği ve bir eleman kazandığı fikrinden yararlanarak tekrar eden işi ortadan kaldırır. Özellikle zaman serileri, sensör verileri, borsa grafikleri ve log analizi gibi alanlarda oldukça kullanışlıdır.
``
Problem neden pahalılaşır?
Elimizde $n$ elemanlı bir dizi ve genişliği $k$ olan bir pencere olsun. Her pencere için maksimum değeri bulmak istediğimizi düşünelim. Naif çözüm, toplam $n-k+1$ pencerenin her birinde $k$ elemanı dolaşır:
\[T(n, k) = (n-k+1) \cdot k\]Bu nedenle karmaşıklık yaklaşık $O(nk)$ olur. Örneğin $n=1.000.000$ ve $k=10.000$ olduğunda, tekrar tekrar yapılan karşılaştırmalar ciddi bir yük yaratır. Kayan pencere yaklaşımında amaç, önceki pencereden öğrendiğimiz bilgiyi çöpe atmamak ve işi $O(n)$ seviyesine indirmektir.
| Yaklaşım | Her pencerenin maliyeti | Toplam karmaşıklık | Güçlü yanı |
|---|---|---|---|
| Naif tarama | $O(k)$ | $O(nk)$ | Yazması çok kolay |
| Sıralı yapı / heap | $O(\log k)$ | $O(n\log k)$ | Esnek güncellemeler |
| Monotonik kuyruk | Amortize $O(1)$ | $O(n)$ | Maksimum/minimum için ideal |
Monotonik kuyruk fikri
Maksimum ararken deque içinde indeksleri tutarız; değerleri değil. Kuyruktaki değerler büyükten küçüğe sıralı kalır. Yeni bir değer geldiğinde, ondan küçük veya eşit olan sondaki adaylar silinir. Çünkü yeni değer hem daha günceldir hem de daha büyüktür; silinen elemanların gelecekte maksimum olma şansı kalmaz.
Pencere ilerlediğinde solda kalan indeks de kuyruktan çıkarılır. Böylece kuyruğun başında her zaman güncel pencerenin maksimum adayının indeksi bulunur. Minimum bulmak için tek değişiklik, karşılaştırma yönünü tersine çevirmektir.
from collections import deque

def pencere_maksimumlari(sayilar, k):
    if k <= 0 or k > len(sayilar):
        return []

    kuyruk = deque()  # Maksimum adaylarının indeksleri
    sonuc = []

    for i, deger in enumerate(sayilar):
        # Pencerenin solundan taşan indeksi temizle.
        while kuyruk and kuyruk[0] <= i - k:
            kuyruk.popleft()

        # Daha küçük adaylar yeni değer karşısında anlamsızdır.
        while kuyruk and sayilar[kuyruk[-1]] <= deger:
            kuyruk.pop()

        kuyruk.append(i)

        # İlk tam pencere oluştuğunda maksimumu kaydet.
        if i >= k - 1:
            sonuc.append(sayilar[kuyruk[0]])

    return sonuc

print(pencere_maksimumlari([1, 3, -1, -3, 5, 3, 6, 7], 3))
# [3, 3, 5, 5, 6, 7]
Kodda her indeks kuyruğa yalnızca bir kez eklenir ve en fazla bir kez çıkarılır. İç içe while döngüleri korkutucu görünse de toplam çıkarma sayısı $n$’i geçmez. Bu yüzden amortize analizle maliyet $O(n)$ olur.
| Hedef | Kuyruk düzeni | Sondan silme koşulu | Baştaki sonuç |
|---|---|---|---|
| Maksimum | Azalan değerler | Yeni değer daha büyük/eşitse | En büyük değer |
| Minimum | Artan değerler | Yeni değer daha küçük/eşitse | En küçük değer |
Sık yapılan hatalar
En yaygın hata değer yerine indeks tutmamaktır. İndeks olmadan bir elemanın pencere dışına çıkıp çıkmadığını güvenilir biçimde anlayamazsınız; aynı değerlerin tekrarlandığı dizilerde hata daha da görünür olur. Ayrıca <= ve >= seçimleri önemlidir: Eşit değerlerde daha yeni indeksi tutmak, eski indeksin daha erken geçersizleşmesini doğal biçimde yönetir.
Kısacası kayan pencere yalnızca bir optimizasyon numarası değildir; hareket eden veri aralıklarında gereksiz hesaplamayı fark etme alışkanlığıdır. Maksimum ve minimum problemlerinde monotonik kuyrukla birleştiğinde, milyonlarca veriyi tek geçişte işleyen zarif bir çözüme dönüşür.
Yorumlar