İçindekiler
Bir sayı listesini sıralamak basit görünebilir; ancak kullanılan yöntem, veri büyüdükçe saniyeleri dakikalara dönüştürebilir. Bu yazıda kabarcık, seçmeli, yerleştirmeli ve Shell sıralamasını aynı arenaya çıkarıyor; teorik karmaşıklıklarını, bellek davranışlarını ve farklı veri boyutlarındaki pratik performanslarını karşılaştırıyoruz. ``
Önce temel kavram: Karmaşıklık
Bir algoritmanın çalışma süresini yalnızca saniyeyle ölçmek yanıltıcıdır; işlemci, programlama dili ve sistem yükü sonucu etkiler. Bu nedenle girdi boyutu $n$ arttığında işlem sayısının nasıl değiştiğini anlatan asimptotik karmaşıklık kullanılır.
Örneğin iç içe iki döngü yaklaşık
\[T(n) = \frac{n(n-1)}{2}\]karşılaştırma yapıyorsa baskın terim $n^2$ olur ve karmaşıklık $O(n^2)$ şeklinde yazılır. Veri miktarını iki katına çıkarmak, çalışma süresini kabaca dört katına çıkarabilir. Küçük listelerde önemsiz görünen bu fark, $n=100.000$ olduğunda algoritmik bir drama dönüşür.
| Algoritma | En iyi | Ortalama | En kötü | Ek bellek | Kararlı mı? |
|---|---|---|---|---|---|
| Kabarcık | $O(n)$ | $O(n^2)$ | $O(n^2)$ | $O(1)$ | Evet |
| Seçmeli | $O(n^2)$ | $O(n^2)$ | $O(n^2)$ | $O(1)$ | Genellikle hayır |
| Yerleştirmeli | $O(n)$ | $O(n^2)$ | $O(n^2)$ | $O(1)$ | Evet |
| Shell | Aralık dizisine bağlı | Yaklaşık $O(n^{1.3})$–$O(n^2)$ | Genellikle $O(n^2)$ | $O(1)$ | Hayır |
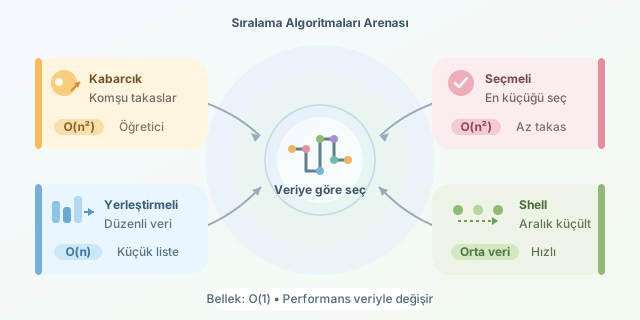
Dört algoritmanın çalışma mantığı
Kabarcık sıralaması, komşu elemanları karşılaştırır ve yanlış sıradaysalar yer değiştirir. Büyük değerler her turda listenin sonuna doğru “kabarcık” gibi yükselir. Takas yapılmayan turda durdurulursa sıralı veride $O(n)$ performans gösterebilir; fakat rastgele büyük verilerde çok fazla karşılaştırma ve takas üretir.
Seçmeli sıralama, her turda sıralanmamış bölümün en küçük elemanını bulup başa taşır. Karşılaştırma sayısı veri zaten sıralı olsa bile pek değişmez. Buna karşılık az takas yapması, yazma maliyetinin yüksek olduğu özel ortamlarda avantaj sağlayabilir.
Yerleştirmeli sıralama, iskambil kâğıtlarını elde dizerken kullandığımız yönteme benzer. Her yeni elemanı soldaki sıralı bölümde uygun konuma yerleştirir. Neredeyse sıralı verilerde az kaydırma yaptığı için oldukça hızlıdır. Bu nedenle gelişmiş sıralama algoritmalarında küçük alt dizileri işlemek amacıyla sıkça kullanılır.
Shell sıralaması ise yerleştirmeli sıralamanın sabırsız kuzenidir. Önce birbirinden uzak elemanları belirli aralıklarla sıralar, ardından aralığı küçültür. Son aşamada aralık $1$ olur; fakat liste önceden büyük ölçüde düzenlendiği için işlem hızlanır.
Python ile karşılaştırmalı deney
Aşağıdaki kod, algoritmaları aynı rastgele verinin kopyaları üzerinde çalıştırır. Böylece bir algoritmanın sıraladığı listenin diğerlerini haksız biçimde avantajlı duruma getirmesi önlenir.
import random
import time

def insertion_sort(a):
    for i in range(1, len(a)):
        value = a[i]
        j = i - 1
        while j >= 0 and a[j] > value:
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = value
    return a

def shell_sort(a):
    gap = len(a) // 2
    while gap > 0:
        for i in range(gap, len(a)):
            value, j = a[i], i
            while j >= gap and a[j - gap] > value:
                a[j] = a[j - gap]
                j -= gap
            a[j] = value
        gap //= 2
    return a

for size in (100, 1000, 5000):
    data = [random.randint(0, 100000) for _ in range(size)]
    for function in (insertion_sort, shell_sort):
        sample = data.copy()
        start = time.perf_counter()
        function(sample)
        elapsed = time.perf_counter() - start
        print(size, function.__name__, elapsed)
perf_counter() kısa süreleri hassas ölçer; copy() ise deney adaletini korur. Güvenilir sonuç için her testi birçok kez çalıştırıp ortalama veya medyan almak gerekir.
| Veri durumu | Mantıklı tercih | Neden? |
|---|---|---|
| Çok küçük liste | Yerleştirmeli | Düşük ek maliyet |
| Neredeyse sıralı | Yerleştirmeli | Az sayıda kaydırma |
| Orta boy rastgele veri | Shell | Uzak elemanları erken düzenler |
| Takas sayısı önemli | Seçmeli | En fazla yaklaşık $n$ takas |
| Eğitim ve görselleştirme | Kabarcık | Mantığı son derece açık |
Sonuç
Kabarcık sıralaması öğretici, seçmeli sıralama az takaslı, yerleştirmeli sıralama küçük veya düzenli veride çevik, Shell sıralaması ise orta ölçekli rastgele veride güçlüdür. Yine de büyük gerçek dünya verilerinde $O(n\log n)$ sınıfındaki hızlı sıralama, birleştirmeli sıralama veya dilin yerleşik sıralama fonksiyonu genellikle daha doğrudur. Kısacası kazanan tek bir algoritma değil; verinin yapısını tanıyıp doğru aracı seçen programcıdır.
Yorumlar