İçindekiler
Yeni bir tedavinin gerçekten işe yarayıp yaramadığını anlamak, birkaç hastanın kendini daha iyi hissettiğini gözlemlemekten çok daha fazlasını gerektirir. Randomize kontrollü çalışmalar, tedavinin etkisini karşılaştırılabilir gruplar üzerinden ölçerken istatistiksel analiz yazılımları da ham verileri bilimsel kanıta dönüştürür. Bu süreçte R, SAS, Stata ve Python gibi araçlar araştırmacıların güçlü yardımcılarıdır; ancak yazılım ne kadar gelişmiş olursa olsun, yanlış tasarlanmış bir deneyi sihirli biçimde düzeltemez.
``
Randomizasyon neden önemlidir?
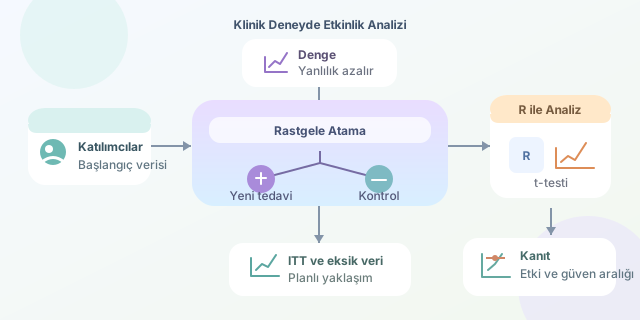
Randomize kontrollü çalışmada katılımcılar genellikle yeni tedavi ve kontrol gruplarına rastgele atanır. Randomizasyonun amacı yaş, hastalık şiddeti ve yaşam tarzı gibi sonucu etkileyebilecek özellikleri gruplar arasında dengelemektir. Böylece gözlenen farkın tedaviden kaynaklandığı iddiası daha güvenilir hâle gelir.
Basit bir sürekli sonuç için tedavi etkisi şöyle ifade edilebilir:
\[\Delta = \bar{X}_{tedavi} - \bar{X}_{kontrol}\]Burada $\Delta$, iki grubun ortalama sonuçları arasındaki farktır. Örneğin düşük skorun daha iyi olduğu bir ağrı ölçeğinde negatif bir $\Delta$, yeni tedavinin lehine olabilir. Bununla birlikte etki büyüklüğü tek başına yeterli değildir; belirsizliği göstermek için güven aralığı da raporlanmalıdır:
\[GA_{95\%} = \hat{\Delta} \pm 1.96 \times SE(\hat{\Delta})\]Güven aralığı hem etkinin olası yönünü hem de klinik açıdan anlamlı değerlerle uyumunu değerlendirmeye yardımcı olur.
Hangi yazılım ne sunar?
| Yazılım | Güçlü yönü | Dikkat edilmesi gereken |
|---|---|---|
| R | Ücretsiz, geniş paket ekosistemi, tekrarlanabilir analiz | Kodlama bilgisi gerektirir |
| SAS | Klinik araştırmalarda yaygın, doğrulama araçları güçlü | Lisans maliyeti yüksektir |
| Stata | İstatistiksel komutları anlaşılır, veri yönetimi pratiktir | Bazı özelleştirmeler sınırlı kalabilir |
| Python | Veri işleme ve makine öğrenmesinde esnektir | Klinik raporlama iş akışları ek kurulum isteyebilir |
Araç seçimi yalnızca popülerliğe göre yapılmamalıdır. Düzenleyici gereksinimler, ekibin deneyimi, denetlenebilirlik ve analizlerin yeniden üretilebilmesi birlikte değerlendirilmelidir.
R ile örnek etkinlik analizi
Aşağıdaki örnekte sonuc değişkeninin yüksek olması daha iyi klinik sonucu temsil etsin. Kod, grupları özetler ve bağımsız iki örneklem t-testi uygular:
library(dplyr)

veri <- read.csv("klinik_deney.csv")

veri %>%
  group_by(grup) %>%
  summarise(
    katilimci = n(),
    ortalama = mean(sonuc, na.rm = TRUE),
    standart_sapma = sd(sonuc, na.rm = TRUE)
  )

model <- t.test(sonuc ~ grup, data = veri)
print(model)
Özet tablo her gruptaki katılımcı sayısını, ortalamayı ve değişkenliği gösterir. t.test() ise ortalama farkına ilişkin hipotez testini ve güven aralığını üretir. Fakat normal dağılım, bağımsızlık ve aykırı değerler gibi varsayımlar kontrol edilmeden sonuçlara güvenilmemelidir.
| Ölçüt | Yanıtladığı soru | Yaygın hata |
|---|---|---|
| Etki büyüklüğü | Tedavi ne kadar fark oluşturdu? | Yalnızca p-değerine bakmak |
| Güven aralığı | Tahmin ne kadar belirsiz? | Geniş aralığı görmezden gelmek |
| p-değeri | Veri, sıfır etki varsayımıyla ne kadar uyumlu? | Etkinin büyüklüğü sanmak |
| Klinik anlamlılık | Fark hasta açısından önemli mi? | İstatistiksel anlamlılıkla eşitlemek |
ITT, eksik veri ve güvenlik
Birincil analiz çoğunlukla tedavi niyetine göre analiz (ITT) yaklaşımını izler: Katılımcılar, tedaviyi tamamlamasalar bile randomize edildikleri grupta değerlendirilir. Bu yaklaşım randomizasyonun sağladığı dengeyi korur. Eksik sonuçların silinmesi ise yanlılığa yol açabileceğinden çoklu atama veya karma etkili modeller gibi yöntemler önceden hazırlanmış analiz planında tanımlanmalıdır.
Etkinlik kadar advers olaylar, tedaviyi bırakma oranları ve ciddi güvenlik sinyalleri de incelenir. Sonuç olarak iyi bir klinik analiz; doğru yazılım, önceden kayıtlı hipotezler, şeffaf kod, uygun istatistiksel model ve klinik uzmanlığın ortak ürünüdür. Bilgisayar hesabı hızlandırır, fakat bilimsel muhakemenin yerini alamaz.
Yorumlar