İçindekiler
Bir metnin içinde desen aramak ilk bakışta basittir: Her konumu dene, karakterleri karşılaştır ve eşleşme bozulunca ilerle. Ancak uzun metinlerde bu yaklaşım pahalılaşır. KMP ve Z-algoritması aynı sorunu doğrusal zamanda çözer; buna rağmen Z dizisi, daha sezgisel tanımı ve farklı problemlere kolay uyarlanması sayesinde kimi zaman KMP’nin meşhur prefix tablosundan daha zarif bir araçtır.
``
Önce ortak düşman: Gereksiz karşılaştırmalar
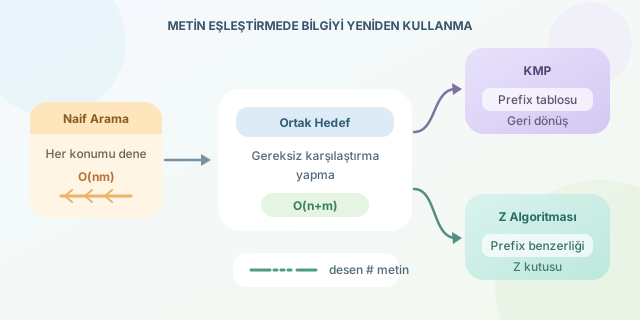
Naif eşleştirmede uzunluğu $n$ olan metin ile uzunluğu $m$ olan desen için en kötü zaman karmaşıklığı $O(nm)$ olabilir. KMP ve Z-algoritması ise daha önce elde edilen eşleşme bilgisini yeniden kullanarak toplam süreyi
\[O(n+m)\]seviyesine indirir. Yani burada KMP gerçekten “çökmüyor”; başlıktaki çöküş, daha çok zihinsel yüküne yönelik küçük bir dramatizasyondur.
KMP neden zor hissediliyor?
KMP, desen için bir prefix tablosu üretir. Genellikle LPS veya $\pi$ dizisi denilen bu yapı, $\pi[i]$ konumunda desenin aynı zamanda suffix olan en uzun öz prefix’inin uzunluğunu saklar.
Örneğin ababaca deseninde eşleşme bozulduğunda başa dönmek yerine, prefix tablosu bize desenin hangi bölümünün hâlâ geçerli olduğunu söyler. Fikir güçlüdür; fakat tabloyu oluştururken kullanılan geri dönüş zinciri yeni başlayanları zorlayabilir:
while j > 0 and pattern[i] != pattern[j]:
    j = pi[j - 1]
Buradaki j = pi[j - 1] satırı algoritmanın kalbidir, ama “Neden tam olarak oraya dönüyoruz?” sorusu çoğu anlatımda havada kalır.
Z dizisinin daha görsel fikri
Bir dizge $S$ için $Z[i]$, S[i:] suffix’i ile bütün dizgenin prefix’i arasındaki en uzun ortak başlangıcın uzunluğudur:
Başka bir ifadeyle Z dizisi, her konumda “Buradan başlayan parça, dizgenin başına kaç karakter benziyor?” diye sorar. Metin eşleştirmek için desen ve metni bir ayraçla birleştiririz:
pattern#text
Bir konumdaki Z değeri desen uzunluğuna eşitse tam eşleşme bulmuşuzdur. # karakterinin desen veya metinde bulunmaması gerekir.
| Özellik | KMP | Z-algoritması |
|---|---|---|
| Temel bilgi | En uzun prefix-suffix | Prefix ile konumsal eşleşme |
| Arama yapısı | Desenin tablosu + metin | desen#metin |
| Karmaşıklık | $O(n+m)$ | $O(n+m)$ |
| Sezgisel soru | “Nereye geri döneyim?” | “Başlangıçla kaç karakter aynı?” |
| Ek kullanım | Akış tabanlı arama | Periyot, tekrar ve sınır analizi |
Orta düzey bir Python uygulaması
Aşağıdaki fonksiyon, daha önce hesaplanmış [left, right] eşleşme kutusunu kullanır. Böylece karakterler gereksiz yere tekrar karşılaştırılmaz:
def z_array(s):
    z = [0] * len(s)
    left = right = 0

    for i in range(1, len(s)):
        if i <= right:
            z[i] = min(right - i + 1, z[i - left])

        while i + z[i] < len(s) and s[z[i]] == s[i + z[i]]:
            z[i] += 1

        if i + z[i] - 1 > right:
            left, right = i, i + z[i] - 1

    return z


def find_matches(text, pattern):
    combined = pattern + "#" + text
    z = z_array(combined)
    offset = len(pattern) + 1
    return [i - offset for i, value in enumerate(z)
            if value == len(pattern)]
find_matches, eşleşmelerin metindeki başlangıç indekslerini döndürür. [left, right] aralığı bilinen bir prefix eşleşmesini temsil eder; z[i-left] ise bu hazır bilginin yeni konuma kopyalanabilecek kısmıdır.
Peki hangisini seçmeliyiz?
Metin karakter karakter akıyorsa ve birleşik dizge oluşturmak istemiyorsak KMP doğal bir seçimdir. Bellek davranışı öngörülebilirdir ve klasik arama senaryolarında son derece etkilidir. Buna karşılık tek bir dizgenin tekrarlarını, periyotlarını, border yapılarını veya birçok prefix eşleşmesini incelemek istiyorsak Z dizisi daha doğrudan sonuç verir.
Sonuç olarak Z-algoritması KMP’yi tahtından indirmez. İkisi de doğrusal zamanlıdır; fark, tuttukları bilginin bakış açısındadır. KMP eşleşme bozulduğunda geçmişi yönetir, Z ise her konumu başlangıçla karşılaştırır. Bazen en zarif algoritma daha hızlı olan değil, problemi zihnimizde en az düğümle anlatandır.
Yorumlar