İçindekiler
Kubernetes kümesinde trafik bazen sakin bir mahalle, bazen de indirim gününde açılmış bir mağaza gibidir. Horizontal Pod Autoscaler (HPA), bu dalgalanmayı izleyip uygulamanın pod sayısını otomatik artırır veya azaltır. Ancak HPA bir “CPU yükseldi, pod ekle” düğmesi değildir; metrikleri hedeflerle karşılaştıran, oran hesaplayan ve kararsızlığı önleyen kontrollü bir karar mekanizmasıdır. Bu mekanizmayı anlamak, hem gereksiz maliyetleri hem de yoğun saatlerde yaşanan gecikmeleri azaltmanın anahtarıdır.
``
HPA kararının matematiği
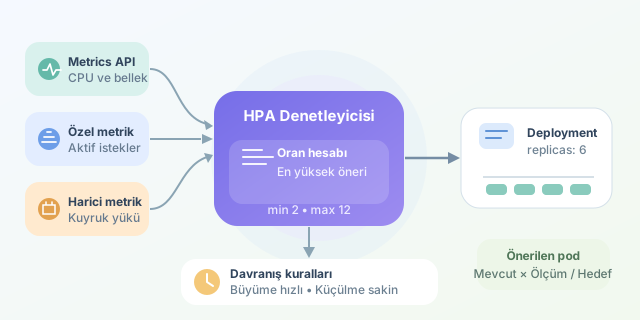
HPA düzenli aralıklarla metrikleri Kubernetes Metrics API, Custom Metrics API veya External Metrics API üzerinden okur. En yaygın örnekte, podların ortalama CPU kullanımını istenen yüzdeyle karşılaştırır. Temel hesap şu şekildedir:
\[\text{İstenen replika} = \left\lceil \text{Mevcut replika} \times \frac{\text{Mevcut metrik}}{\text{Hedef metrik}} \right\rceil\]Örneğin 4 pod çalışan bir API’nin ortalama CPU kullanımı %90, HPA hedefi ise %60 olsun. Hesap $\lceil 4 \times 90/60 \rceil = 6$ sonucunu verir. HPA, Deployment nesnesinin replicas alanını 6’ya günceller; ReplicaSet de eksik iki podu oluşturur.
| Durum | Mevcut CPU | Hedef CPU | 4 Pod İçin Öneri |
|---|---|---|---|
| Yük düşük | %30 | %60 | 2 pod |
| Hedefte | %60 | %60 | 4 pod |
| Yüksek trafik | %90 | %60 | 6 pod |
CPU ve bellek metriklerinde hedef, genellikle pod başına kaynak isteğine (requests) göre kullanım yüzdesidir. Bu nedenle CPU request tanımlamadan yüzde bazlı HPA kullanmak, pusulasız yön bulmaya benzer: HPA kullanılabilir bir referans bulamaz.
Birden çok metrikte hangi karar kazanır?
HPA aynı anda CPU, bellek, pod başına özel metrik ve harici metrik izleyebilir. Her metrik için ayrı bir replika önerisi üretir ve en yüksek öneriyi seçer. Bu yaklaşım, örneğin CPU normal görünürken kuyruktaki iş sayısı yükseliyorsa uygulamanın yeterince hızlı büyümesini sağlar.
| Metrik türü | Ölçtüğü şey | Uygun senaryo |
|---|---|---|
| Resource | CPU veya bellek tüketimi | Web API, genel iş yükü |
| Pods | Pod başına uygulama metriği | Aktif bağlantı sayısı |
| Object | Belirli Kubernetes nesnesi metriği | Ingress istek oranı |
| External | Küme dışı kaynaktan veri | Kafka lag, bulut kuyruğu |
Aşağıdaki örnek, CPU ortalamasını %65’te tutarken aynı zamanda pod başına 30 aktif istek hedefler:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api
  minReplicas: 2
  maxReplicas: 12
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 65
    - type: Pods
      pods:
        metric:
          name: active_requests
        target:
          type: AverageValue
          averageValue: "30"
Bu manifestte active_requests metriğinin Custom Metrics API üzerinden sunulması gerekir. Prometheus Adapter, Prometheus’taki uygulama metriklerini Kubernetes’in anlayacağı biçime dönüştürmek için sık kullanılan çözümdür.
Davranışı özelleştirmek: hız limitleri ve sakinleşme süresi
Ani dalgalanmalar HPA’nın sürekli büyüyüp küçülmesine, yani “flapping” davranışına yol açabilir. behavior alanı, ölçekleme hızını ve küçültme kararlarının ne kadar bekletileceğini belirler. Özellikle scale down işlemini temkinli yapmak, kısa süreli trafik düşüşlerinde podların gereksiz kapatılmasını engeller.
behavior:
  scaleUp:
    stabilizationWindowSeconds: 0
    policies:
      - type: Percent
        value: 100
        periodSeconds: 60
  scaleDown:
    stabilizationWindowSeconds: 300
    policies:
      - type: Percent
        value: 25
        periodSeconds: 60
Bu ayar, büyümede bir dakikada pod sayısını en fazla %100 artırır; küçülmede ise son beş dakikanın daha güvenli önerilerini dikkate alır ve dakikada en fazla %25 azaltır. HPA’yı doğrulamak için kubectl describe hpa api-hpa komutunu çalıştırın. Burada güncel metrikler, hedefler, hesaplanan replika sayısı ve başarısız metrik sorguları görünür. İyi bir HPA yapılandırması yalnızca hızlı ölçeklenmez; doğru metriği seçer, kaynak isteklerini tanımlar ve sistemin ritmini bozmadan hareket eder.
Yorumlar