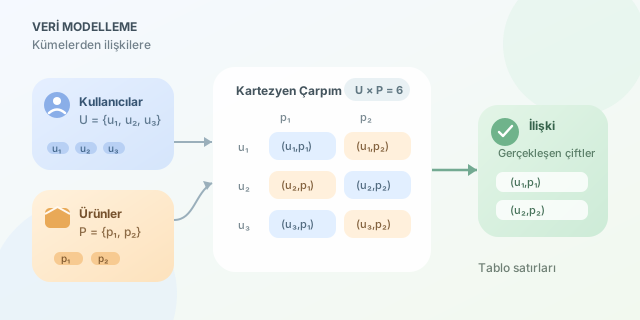
Bir alışveriş uygulamasındaki kullanıcıları, ürünleri ve siparişleri nasıl düzenli biçimde temsil edebiliriz? Cevap yalnızca sınıflarda veya veritabanı tablolarında değil, bunların matematiksel atası olan küme teorisinde saklıdır. Kümeler nesneleri gruplandırırken Kartezyen çarpım, farklı gruplardaki nesneler arasında kurulabilecek ilişkilerin uzayını oluşturur. Kısacası veri modelleme sahnesinin arkasında sessizce çalışan matematik ekibiyle tanışmaya hazır olun! ``
Küme nedir?
Küme, belirli bir özelliğe göre bir araya getirilmiş farklı elemanlar topluluğudur. Örneğin bir sistemdeki kullanıcı kimliklerini şöyle gösterebiliriz:
\[U = \{u_1, u_2, u_3\}\]Ürünler kümesi ise şu olsun:
\[P = \{p_1, p_2\}\]Bir elemanın kümeye ait olması $u_1 \in U$, ait olmaması ise $p_1 \notin U$ biçiminde yazılır. Bilgisayar biliminde kümeler; benzersiz kullanıcılar, izinler, etiketler, düğümler veya durumlar gibi tekrar içermemesi gereken verileri modellemek için kullanılır.
Temel küme işlemleri
İki küme arasındaki işlemler, farklı veri kaynaklarını karşılaştırmanın matematiksel karşılığıdır.
| İşlem | Gösterim | Veri modellemedeki anlamı |
|---|---|---|
| Birleşim | $A \cup B$ | İki kaynaktaki tüm benzersiz kayıtlar |
| Kesişim | $A \cap B$ | Her iki kaynakta bulunan kayıtlar |
| Fark | $A \setminus B$ | Yalnızca ilk kaynakta bulunanlar |
| Alt küme | $A \subseteq B$ | Bir grubun tamamen diğerinde yer alması |
| Tümleyen | $A^c$ | Belirlenen evren içinde gruba ait olmayanlar |
Örneğin aktif kullanıcılar $A$, e-posta aboneleri $E$ olsun. $A \cap E$, hem aktif hem de abone olan kullanıcıları verir. $E \setminus A$ ise bülteni alan fakat artık aktif olmayan kullanıcıları gösterir. Pazarlama ekibi bu kümeyi görünce muhtemelen “geri kazanım kampanyası!” diye bağıracaktır.
Python’ın set veri tipi bu işlemleri doğrudan destekler:
aktif = {'Ayşe', 'Can', 'Ece'}
aboneler = {'Can', 'Ece', 'Mert'}

hedef_kitle = aktif & aboneler
pasif_aboneler = aboneler - aktif

print(hedef_kitle)      # {'Can', 'Ece'}
print(pasif_aboneler)   # {'Mert'}
Burada & kesişimi, - ise küme farkını hesaplar. Listelerden farklı olarak kümeler yinelenen değerleri otomatik olarak eler ve üyelik sorgularını genellikle hızlı gerçekleştirir.
Kartezyen çarpım: Bütün olası eşleşmeler
$A$ ve $B$ kümelerinin Kartezyen çarpımı, ilk elemanı $A$’dan, ikinci elemanı $B$’den gelen bütün sıralı ikilerdir:
\[A \times B = \{(a,b) \mid a \in A \land b \in B\}\]Kullanıcı ve ürün kümelerimiz için:
\[U \times P = \{(u_1,p_1),(u_1,p_2),(u_2,p_1),(u_2,p_2),(u_3,p_1),(u_3,p_2)\}\]Eleman sayısı çarpım kuralıyla bulunur:
\[\vert U \times P\vert = \vert U\vert \cdot \vert P\vert = 3 \cdot 2 = 6\]| Yapı | Eleman biçimi | Sıra önemli mi? |
|---|---|---|
| Küme | $a$ | Hayır |
| Sıralı ikili | $(a,b)$ | Evet |
| Kartezyen çarpım | $(a,b)$ koleksiyonu | Evet |
| İlişki | $A \times B$’nin alt kümesi | Evet |
Her olası kullanıcı-ürün çifti gerçek bir satın alma değildir. Satın alma ilişkisi, $U \times P$ kümesinin yalnızca gerçekleşmiş çiftlerini içeren bir alt kümedir. İlişkisel veritabanlarının temel fikri de buradan gelir: tablolar ilişkileri, satırlar ise belirli sıralı demetleri temsil eder.
Python’da olası eşleşmeleri üretmek için itertools.product kullanılabilir:
from itertools import product

kullanicilar = ['u1', 'u2', 'u3']
urunler = ['p1', 'p2']

olasi_eslesmeler = list(product(kullanicilar, urunler))
print(olasi_eslesmeler)
Bu yaklaşım öneri sistemi adayları veya test kombinasyonları üretirken yararlıdır. Ancak iki küme büyüdükçe sonuç $\vert A\vert \cdot \vert B\vert $ hızında genişler. Bu nedenle veritabanlarında filtresiz CROSS JOIN kullanmak, küçük bir sorguyu satır üreten bir ejderhaya dönüştürebilir.
Küme teorisi verilerin hangi gruplara ait olduğunu, Kartezyen çarpım ise bu gruplar arasında hangi eşleşmelerin mümkün olduğunu açıklar. İlişkiler, sorgular, yetkilendirme sistemleri ve grafik modelleri bu iki fikir üzerine kuruludur. Matematik burada soyut bir süs değil; düzenli, tutarlı ve ölçeklenebilir yazılım tasarımının görünmez iskeletidir.
Yorumlar