İçindekiler
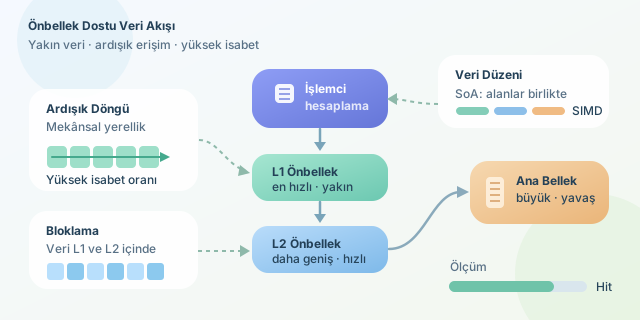
Modern işlemciler son derece hızlıdır; ancak ihtiyaç duydukları veriyi ana bellekten beklemek zorunda kaldıklarında pahalı bir spor arabayı trafik ışığında bekletmeye dönüşürler. Döngülerimizi ve veri yapılarımızı işlemci önbelleğine uygun tasarlamak, daha yüksek saat hızına ihtiyaç duymadan programı birkaç kat hızlandırabilir.
``
İşlemci neden önbelleğe ihtiyaç duyar?
CPU ile RAM aynı hızda çalışmaz. İşlemci bir komutu birkaç çevrimde tamamlayabilirken RAM erişimi yüzlerce çevrim sürebilir. Bu farkı azaltmak için işlemci ile RAM arasına küçük fakat hızlı önbellek katmanları yerleştirilir.
| Katman | Yaklaşık kapasite | Göreli hız | Özellik |
|---|---|---|---|
| L1 cache | 32–128 KB | En hızlı | Genellikle çekirdeğe özeldir |
| L2 cache | 256 KB–2 MB | Çok hızlı | L1’den büyük, biraz daha yavaş |
| L3 cache | Birkaç MB | Orta | Çekirdekler arasında paylaşılabilir |
| RAM | GB düzeyi | Yavaş | Büyük veri deposudur |
Aranan veri önbellekte bulunursa cache hit, bulunamazsa cache miss oluşur. Basitleştirilmiş ortalama erişim süresi şöyle düşünülebilir:
\[T_{ortalama} = h \cdot T_{cache} + (1-h) \cdot T_{RAM}\]Burada $h$ cache hit oranıdır. RAM çok daha yavaş olduğundan, $h$ değerindeki küçük bir artış bile toplam süreyi ciddi biçimde azaltabilir.
Mekânsal ve zamansal yerellik
Önbellek RAM’den tek bir değişken getirmez; genellikle 64 baytlık bir cache line taşır. Bir elemana eriştiğimizde komşu elemanlar da gelir. Ardışık elemanları kullanmak mekânsal yerellik, aynı veriyi kısa süre içinde tekrar kullanmak ise zamansal yerellik sağlar.
C ve C++ gibi dillerde iki boyutlu diziler satır öncelikli saklanır. Bu nedenle döngü sırası önemlidir:
#define N 2048
int matrix[N][N];
long long toplam = 0;

// Cache dostu: Bellekte ardışık elemanlar okunur.
for (int i = 0; i < N; i++) {
    for (int j = 0; j < N; j++) {
        toplam += matrix[i][j];
    }
}
İç döngüde j değiştiği için matrix[i][j] elemanları art arda okunur. Döngüleri ters çevirmek ise her erişimde farklı bir satıra sıçrayabilir:
// Cache açısından zayıf: Büyük adımlarla bellekte gezinir.
for (int j = 0; j < N; j++) {
    for (int i = 0; i < N; i++) {
        toplam += matrix[i][j];
    }
}
Her iki kod da aynı matematiksel sonucu üretir ve zaman karmaşıklıkları $O(N^2)$ olur. Buna rağmen gerçek çalışma süreleri dramatik biçimde farklılaşabilir. Big-O, bellek erişim maliyetini tek başına anlatmaz.
Veri yapısının dizilişi: AoS ve SoA
Bir oyundaki parçacıkları düşünelim:
struct Parca {
    float x, y, z;
    float hiz;
    int renk;
};

struct Parca parcalar[1000000];
Bu yaklaşım Array of Structures (AoS) olarak adlandırılır. Yalnızca konumları güncelliyorsak kullanılmayan renk gibi alanlar da cache line içine taşınır. Alternatif Structure of Arrays (SoA) düzeninde alanlar ayrılır:
struct Parcalar {
    float x[1000000];
    float y[1000000];
    float z[1000000];
    float hiz[1000000];
    int renk[1000000];
};
| Düzen | Güçlü olduğu durum | Zayıf olduğu durum |
|---|---|---|
| AoS | Bir nesnenin tüm alanları birlikte kullanılıyorsa | Yalnızca birkaç alan işleniyorsa |
| SoA | Aynı alan topluca işleniyorsa, SIMD kullanılıyorsa | Tek nesnenin tüm alanlarına sık erişiliyorsa |
Büyük veriyi bloklar hâlinde işlemek
Matris çarpımı gibi algoritmalarda veri L1 veya L2’ye sığmayabilir. Blocking ya da tiling, problemi önbelleğe sığan küçük parçalara ayırır:
const int B = 32;

for (int ii = 0; ii < N; ii += B)
    for (int kk = 0; kk < N; kk += B)
        for (int i = ii; i < ii + B; i++)
            for (int k = kk; k < kk + B; k++)
                sonuc[i] += matrix[i][k] * vektor[k];
Blok boyutu donanıma ve veri tipine göre ölçülerek seçilmelidir. Gereğinden büyük bloklar önbellekten taşar; çok küçük bloklar ise döngü yönetimi maliyetini artırır.
Sonuç olarak ardışık erişim, tekrar kullanılan veriyi yakın tutma, uygun veri düzeni ve bloklama cache hit oranını yükseltir. En doğru optimizasyon için tahminde bulunmak yerine perf, Valgrind Cachegrind veya işlemci performans sayaçlarıyla cache miss değerlerini ölçmek gerekir. Çünkü hızlı kod yalnızca daha az işlem yapan değil, işlemciyi verisiz bırakmayan koddur.
Yorumlar