İçindekiler
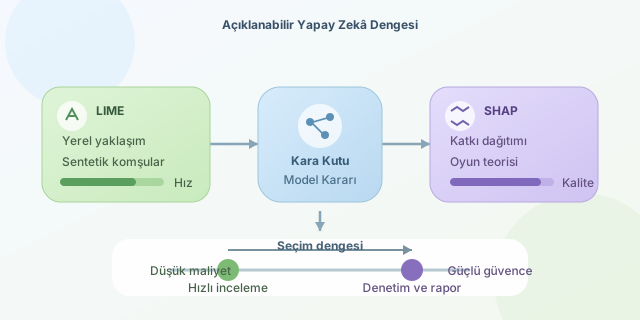
Bir kredi risk modelinin neden “reddet” dediğini ya da bir görüntü sınıflandırıcının neden “kedi” gördüğünü bilmek, model doğruluğu kadar önemlidir. Açıklanabilir yapay zekâ (XAI), kara kutu modellerin kararlarını insan diline yaklaştırmayı hedefler. Bu alanda en popüler iki yaklaşım LIME ve SHAP’tir. İkisi de özellik katkılarını sunar; ancak açıklamanın güvenilirliği, tutarlılığı ve üretim ortamındaki maliyeti bakımından oldukça farklı karakterlere sahiptir.
``
Ortak amaç, farklı teorik temel
LIME (Local Interpretable Model-agnostic Explanations), tek bir tahminin çevresinde sentetik örnekler üretir. Karmaşık modeli bu dar komşulukta çalıştırır ve sonuçları basit, yorumlanabilir bir modelle (çoğunlukla doğrusal regresyon) yaklaşıklar. Temel fikir şöyledir:
\[\hat{g}=\arg\min_{g\in G}\;L(f,g,\pi_x)+\Omega(g)\]Burada $f$ kara kutu model, $g$ yerel açıklama modeli, $\pi_x$ örneklerin incelenen $x$ noktasına yakınlık ağırlığı, $L$ açıklama hatası ve $\Omega$ ise açıklamanın karmaşıklık cezasıdır. LIME, “bu kararın hemen çevresinde model nasıl davranıyor?” sorusuna cevap verir.
SHAP ise oyun teorisindeki Shapley değerlerini kullanır. Her özellik, tahmin oyununa katkı yapan bir oyuncu kabul edilir. Bir özelliğin katkısı, tüm olası özellik sıralamalarındaki marjinal katkısının ortalamasıdır:
\[\phi_i=\sum_{S\subseteq F\setminus\{i\}}\frac{\vert S\vert !(\vert F\vert -\vert S\vert -1)!}{\vert F\vert !}[f(S\cup\{i\})-f(S)]\]Bu yaklaşım, tahmini genellikle başlangıç değeri ile katkıların toplamı olarak ifade eder: $f(x)=\phi_0+\sum_i\phi_i$. Matematik güzel; fakat tüm alt kümeleri hesaplamak, özellik sayısı arttığında pahalılaşır.
| Ölçüt | LIME | SHAP |
|---|---|---|
| Açıklama türü | Yerel yaklaşık model | Özellik katkılarının oyun teorik dağıtımı |
| Model bağımsızlığı | Evet | KernelSHAP ile evet; TreeSHAP gibi özel sürümler de var |
| Tutarlılık | Örnekleme nedeniyle değişken olabilir | Aksiyomlar sayesinde daha güçlü teorik garanti |
| Küresel içgörü | Yerel sonuçların toplanmasıyla sınırlı | Yerel değerler agregasyonla güçlü küresel analize dönüşür |
Yorum kalitesi: Hızlı sezgi mi, sağlam muhasebe mi?
LIME’ın en büyük avantajı, açıklamayı insanın kolay okuyacağı küçük bir doğrusal modele dönüştürmesidir. Örneğin spam sınıflandırmasında “ücretsiz” sözcüğü $+0.42$, “toplantı” sözcüğü $-0.18$ etkide bulunuyor denebilir. Ancak sentetik komşuların nasıl üretildiği çok kritiktir. Gerçek hayatta hiç oluşmayacak özellik kombinasyonları üretmek, açıklamayı ikna edici ama yanıltıcı kılabilir. Aynı veri noktası için farklı rastgele tohumlar farklı katsayılar verebilir.
SHAP, katkıları daha sistematik dağıttığı için özellikle denetim, regülasyon ve paydaş güveni gereken senaryolarda öne çıkar. “Gelir”, “borç oranı” ve “kredi geçmişi”nin tahmine etkisi daha karşılaştırılabilir biçimde raporlanır. Buna rağmen SHAP da nedensellik kanıtlamaz: yüksek SHAP değeri, özelliğin kararı model içinde etkilediğini söyler; gerçek dünyada neden olduğunu değil.
Hesaplama maliyeti ve pratik seçim
Naif Shapley hesabı $O(2^M)$ karmaşıklığındadır; $M$ özellik sayısıdır. KernelSHAP bu maliyeti örnekleme ile azaltır ama yine de geniş veri kümelerinde ağır olabilir. TreeSHAP, ağaç tabanlı modeller için yapısal optimizasyonlar kullanarak maliyeti ciddi biçimde düşürür. LIME ise seçilen sentetik örnek sayısı $N$ kadar model çağrısı yaptığından kabaca $O(N)$ tahmin maliyetine sahiptir.
| Senaryo | Daha uygun tercih | Gerekçe |
|---|---|---|
| Hızlı tekil vaka incelemesi | LIME | Az sayıda örnekle hızlı, sezgisel açıklama |
| XGBoost veya LightGBM üretim modeli | TreeSHAP | Yüksek kalite ve optimize edilmiş hesaplama |
| Regülasyon raporu ve adalet analizi | SHAP | Tutarlı katkılar, küresel özet grafikler |
| Çok pahalı derin öğrenme API’si | LIME veya örneklenmiş SHAP | Model çağrı bütçesi dikkatle yönetilebilir |
Aşağıdaki Python örneği, ağaç modelinde SHAP değerlerini üretir. Her satırın katkısını hesaplamak için modelin yapısından yararlanır:
import shap
from lightgbm import LGBMClassifier

model = LGBMClassifier().fit(X_train, y_train)
explainer = shap.TreeExplainer(model)
values = explainer.shap_values(X_test)

# İlk gözlemde hangi özelliklerin tahmini yukarı/aşağı ittiğini gösterir
shap.plots.waterfall(shap.Explanation(
    values=values[0][0],
    base_values=explainer.expected_value[0],
    data=X_test.iloc[0],
    feature_names=X_test.columns
))
Sonuç olarak LIME, hızlı bir yerel “dedektif notu”; SHAP ise daha maliyetli fakat muhasebesi güçlü bir “katkı raporu” gibidir. En iyi seçim, yalnızca açıklama hızına değil model türüne, özellik sayısına, kararın riskine ve açıklamanın kim tarafından kullanılacağına göre yapılmalıdır.
Yorumlar