İçindekiler
Büyük Dil Modelleri (Large Language Models, LLM), ilk bakışta insan gibi konuşan sihirli makineler gibi görünür. Perdenin arkasında ise milyarlarca sayısal ağırlık, devasa metin koleksiyonları ve oldukça basit görünen bir hedef vardır: Bir sonraki token’ın ne olacağını tahmin etmek. Bu tahmin görevi; sohbet, özetleme, çeviri, kod üretimi ve hatta adım adım problem çözme gibi şaşırtıcı yeteneklere dönüşür. ``
Temel fikir: Metni sayılara çevirmek
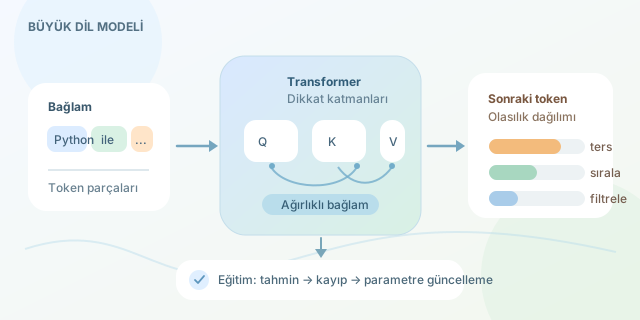
Bir LLM doğrudan kelimeleri değil, token adı verilen metin parçalarını işler. Token bazen bir kelime, bazen ek, noktalama işareti veya kelimenin bir bölümü olabilir. Örneğin programlama tek token olabileceği gibi kullanılan sözlüğe göre birkaç parçaya ayrılabilir.
Modelin hedefi, önceki token’lar verildiğinde sonraki token için bir olasılık dağılımı üretmektir:
\[P(x_t \mid x_1, x_2, ..., x_{t-1})\]Burada $x_t$ sıradaki token, önceki ifadeler ise bağlamdır. “Python ile listeyi…” ifadesinden sonra model; ters, sırala veya filtrele gibi devamların olasılıklarını hesaplar. En yüksek olasılıklı seçeneği almak mümkün olsa da, yaratıcı üretim için sıcaklık (temperature) gibi ayarlarla kontrollü rastgelelik eklenebilir.
Transformer neden oyunun kurallarını değiştirdi?
Modern LLM’lerin ana mimarisi genellikle Transformer‘dır. En güçlü fikri olan self-attention, cümledeki her token’ın diğer token’lara ne kadar dikkat etmesi gerektiğini öğrenmesini sağlar. Böylece model, uzun bir paragrafta geçen zamirin hangi isme işaret ettiğini veya kodda tanımlanan değişkenin daha sonra nerede kullanıldığını daha iyi kavrar.
Attention mekanizmasının özeti şöyledir:
\[\text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]$Q$ sorguyu, $K$ anahtarları, $V$ ise taşınacak bilgiyi temsil eder. Formül ilk anda korkutucu dursa da anlamı basittir: Model, mevcut token için bağlamdaki ilgili parçaları ağırlıklandırır ve onlardan bilgi toplar.
| Kavram | Geleneksel yaklaşım | LLM yaklaşımı |
|---|---|---|
| Dil temsili | Elle yazılmış kurallar | Veriden öğrenilen vektörler |
| Bağlam | Kısıtlı pencere veya kurallar | Attention ile geniş bağlam |
| Çıktı | Sabit şablonlar | Olasılıksal, yeni içerik |
| Öğrenme | Göreve özel veri | Ön eğitim + ince ayar |
Parametreler: Modelin ayar düğmeleri
Parametreler, eğitim sırasında değişen milyarlarca sayıdır. Bir parametre tek başına “Türkçe bilir” anlamına gelmez; bilgi, ağın tamamına dağılmış durumdadır. Eğitimde modelin tahmini ile gerçek sonraki token arasındaki fark, çapraz entropi kaybı ile ölçülür:
\[L=-\sum_i y_i\log(\hat{y}_i)\]Ardından gradyan inişi, parametreleri kaybı azaltacak yönde günceller. Milyarlarca örnek boyunca tekrar eden bu süreç, dilbilgisi örüntülerini, programlama kalıplarını ve metinlerdeki ilişkileri istatistiksel olarak kodlar.
# Basitleştirilmiş token seçimi: gerçek modeller çok daha karmaşıktır.
import random

olasılıklar = {"yaz": 0.55, "oluştur": 0.30, "çalıştır": 0.15}
sonraki_token = random.choices(
    list(olasılıklar.keys()),
    weights=list(olasılıklar.values())
)[0]

print("Modelin seçimi:", sonraki_token)
Bu örnek, üretimin özündeki olasılıksal seçimi gösterir; gerçek LLM’lerde olasılıklar binlerce hatta yüz binlerce token için sinir ağı tarafından hesaplanır.
Ön eğitim, hizalama ve sınırlar
Ön eğitim modeli genel dil yeteneğiyle donatır. Sonrasında talimat örnekleriyle yapılan ince ayar, modelin “soruyu anlayıp yararlı cevap verme” davranışını geliştirir. İnsan geri bildirimi veya yapay geri bildirimle hizalama yapılması da daha güvenli ve tercih edilen yanıtları destekler.
Ancak LLM’ler bir veritabanı ya da mutlak doğruluk makinesi değildir. Akıcı biçimde yanlış bilgi üretebilir; buna halüsinasyon denir. Bu nedenle kritik alanlarda kaynak doğrulama, araç kullanımı, testler ve insan denetimi zorunludur. LLM’i her şeyi bilen bir kâhin değil, çok hızlı bir taslak yazarı ve olasılık motoru olarak görmek en sağlıklı yaklaşımdır.
Yorumlar