İçindekiler
Milyarlarca parametreye sahip bir dil modelini kendi verilerimizle eğitmek kulağa pahalı ekran kartlarıyla dolu bir veri merkezi gerektiriyormuş gibi gelebilir. LoRA, yani Low-Rank Adaptation, modelin tamamını değiştirmek yerine küçük ve eğitilebilir ek matrisler kullanarak bu maliyeti ciddi biçimde azaltır. Böylece tek bir güçlü tüketici ekran kartıyla bile alan odaklı modeller geliştirmek mümkün hâle gelir. ``
Tam ince ayar neden pahalıdır?
Tam ince ayarda modelin bütün parametreleri güncellenir. Örneğin 7 milyar parametreli bir modelde yalnızca ağırlıkları 16 bit hassasiyetle saklamak yaklaşık olarak şu belleği tüketir:
\[7 \times 10^9 \times 2\ \text{bayt} \approx 14\ \text{GB}\]Ancak eğitim sırasında ağırlıkların yanında gradyanlar ve Adam gibi optimizasyon algoritmalarının durumları da tutulur. Bu nedenle gerçek bellek ihtiyacı 14 GB’ın birkaç katına çıkabilir. LoRA’nın temel fikri, bu dev ağırlık matrislerini dondurup yalnızca küçük eklemeleri eğitmektir.
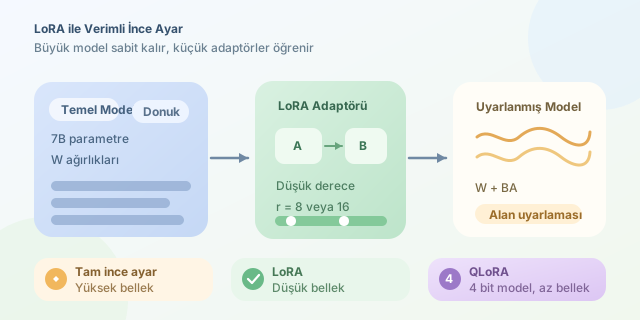
Bir katmandaki ağırlık matrisi $W$ olsun. Tam ince ayar, doğrudan $W$ matrisini değiştirir. LoRA ise güncellemeyi iki düşük dereceli matrisin çarpımı olarak temsil eder:
\[W' = W + \Delta W, \qquad \Delta W = BA\]Burada $A \in \mathbb{R}^{r \times d}$ ve $B \in \mathbb{R}^{k \times r}$ matrisleridir. $r$ değeri, yani rank, genellikle $d$ ve $k$ boyutlarından çok küçüktür. Örneğin 4096 × 4096 boyutlu bir matrisi tamamen eğitmek yaklaşık 16,7 milyon parametre gerektirirken $r=8$ kullanan LoRA yalnızca $4096 \times 8 + 8 \times 4096 = 65.536$ parametre ekler.
| Yöntem | Eğitilen parametreler | Bellek ihtiyacı | Kullanım amacı |
|---|---|---|---|
| Tam ince ayar | Modelin tamamı | Çok yüksek | Kapsamlı davranış değişikliği |
| LoRA | Küçük adaptörler | Düşük | Alan veya görev uyarlaması |
| QLoRA | Kuantize model + LoRA | Çok düşük | Sınırlı GPU belleğiyle eğitim |
LoRA hangi katmanlara uygulanır?
Transformer modellerinde LoRA çoğunlukla attention mekanizmasının query ve value projeksiyonlarına uygulanır. Daha güçlü bir uyarlama için key, output veya ileri beslemeli ağ katmanları da hedeflenebilir. Hedef sayısı arttıkça eğitilebilir parametre miktarı ve bellek kullanımı yükselir.
Rank değeri kapasiteyi belirler. Küçük ve düzenli bir veri kümesinde 8 veya 16 yeterli olabilir. Karmaşık görevlerde 32 ya da 64 denenebilir. lora_alpha, adaptör katkısını ölçekler; pratikte etkili ölçek yaklaşık olarak $\alpha/r$ oranıyla ilişkilidir. lora_dropout ise aşırı öğrenmeyi azaltmaya yardımcı olur.
Hugging Face PEFT ile örnek
Aşağıdaki kod, mevcut bir nedensel dil modeline LoRA adaptörleri ekler. PEFT kütüphanesi temel ağırlıkları otomatik olarak dondurur ve yalnızca seçilen adaptörleri eğitilebilir bırakır.
from transformers import AutoModelForCausalLM
from peft import LoraConfig, get_peft_model

model = AutoModelForCausalLM.from_pretrained(
    "mistralai/Mistral-7B-v0.1",
    torch_dtype="auto",
    device_map="auto"
)

config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    target_modules=["q_proj", "v_proj"],
    task_type="CAUSAL_LM"
)

model = get_peft_model(model, config)
model.print_trainable_parameters()
Bu aşamadan sonra model, Trainer veya özel bir PyTorch eğitim döngüsüyle eğitilebilir. Eğitim sonucunda tüm model yerine çoğunlukla birkaç yüz megabaytlık adaptör dosyaları kaydedilir. Aynı temel model üzerinde müşteri desteği, hukuk veya yazılım geliştirme gibi farklı görevler için ayrı adaptörler taşınabilir.
QLoRA ile maliyeti daha da düşürmek
QLoRA, temel modeli genellikle 4 bit olarak belleğe yüklerken LoRA adaptörlerini daha yüksek hassasiyetle eğitir. Bu yaklaşım model ağırlıklarının kapladığı alanı büyük ölçüde azaltır. Bununla birlikte kuantizasyon küçük kalite kayıpları doğurabilir ve donanım uyumluluğu kontrol edilmelidir.
Başarılı bir çalışma için temiz eğitim verisi, doğrulama kümesi ve uygun öğrenme oranı kritik önemdedir. LoRA donanım faturasını küçültür; fakat kötü veriyi sihirli biçimde iyi modele dönüştürmez. En güvenli yaklaşım küçük bir rank ile başlayıp doğrulama sonuçlarına göre kapasiteyi artırmaktır.
Yorumlar