İçindekiler
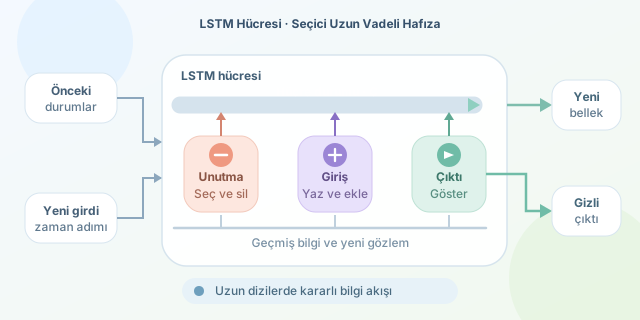
Bir romanın ilk bölümündeki karakteri son bölümde hatırlamak ya da aylar süren sensör kayıtlarındaki kritik bir değişimi yakalamak, sinir ağları için göründüğünden daha zordur. Standart Tekrarlayan Sinir Ağları (RNN), geçmiş bilgisini gizli durumunda taşısa da uzun dizilerde bu bilgiyi kaybetmeye eğilimlidir. LSTM (Long Short-Term Memory), yani Uzun Kısa Süreli Hafıza hücreleri, hangi bilgiyi saklayacağını, hangisini unutacağını ve ne zaman çıktı üreteceğini öğrenen kapılarıyla bu soruna akıllı bir çözüm getirir.
``
RNN’ler neden uzun vadede zorlanır?
Bir RNN, her zaman adımında önceki gizli durumunu ve yeni girdiyi birleştirir:
\[h_t = \tanh(W_h h_{t-1} + W_x x_t + b)\]Eğitim sırasında hata, zaman içinde geriye doğru yayılır. Bu esnada gradyanlar ardışık çarpımlara maruz kalır. Değerler çok küçülürse kaybolan gradyan, çok büyürse patlayan gradyan problemi görülür. Sonuç olarak ağ, cümlenin başındaki özneyi veya yüzlerce adım önceki sıcaklık anomalısını güvenilir biçimde bağlama dahil edemez.
| Özellik | Standart RNN | LSTM |
|---|---|---|
| Bellek taşıma | Tek gizli durum | Hücre durumu ve gizli durum |
| Uzun bağımlılıklar | Genellikle zayıf | Çok daha güçlü |
| Bilgi kontrolü | Dolaylı | Öğrenilebilir kapılarla açık |
| Hesaplama maliyeti | Daha düşük | Daha yüksek |
| Kullanım örneği | Kısa diziler | Metin, konuşma, uzun zaman serileri |
LSTM’nin gizli kasası: hücre durumu
LSTM’nin merkezinde, zaman boyunca nispeten kesintisiz ilerleyen hücre durumu $C_t$ bulunur. Bunu bir not defteri gibi düşünebilirsiniz: Ağ, deftere eski notların ne kadarını bırakacağını ve yeni notlardan ne kadar ekleyeceğini kapılar aracılığıyla belirler. Bu yapı, gradyanın daha kararlı akmasına yardımcı olur.
İlk kapı, unutma kapısıdır. Önceki hücre belleğinin hangi bölümünün korunacağını seçer:
\[f_t = \sigma(W_f[h_{t-1}, x_t] + b_f)\]Buradaki sigmoid fonksiyonu $ 3a7ıktıyı $0$ ile $1$ arasına sıkıştırır. Değer $0$ ise “bu bilgiyi sil”, $1$ ise “olduğu gibi sakla” anlamına gelir. Ardından giriş kapısı, yeni aday bilginin ne kadarının belleğe yazılacağını yönetir:
\[i_t = \sigma(W_i[h_{t-1},x_t]+b_i), \qquad \tilde{C}_t = \tanh(W_C[h_{t-1},x_t]+b_C)\]Bellek güncellemesi iki fikri birleştirir: eski bilgiyi seçerek tutmak ve yeni bilgiyi seçerek eklemek.
\[C_t = f_t * C_{t-1} + i_t * \tilde{C}_t\]Son olarak çıktı kapısı, güncel belleğin dışarıya ne kadarının gösterileceğini belirler:
\[o_t = \sigma(W_o[h_{t-1},x_t]+b_o), \qquad h_t = o_t * \tanh(C_t)\]Keras ile küçük bir LSTM örneği
Aşağıdaki model, zaman serisi pencerelerinden tek bir sayısal tahmin üretir. Örneğin geçmiş 30 günlük satış verisinden sonraki günün satışını kestirmek için uyarlanabilir.
from tensorflow.keras import Sequential
from tensorflow.keras.layers import LSTM, Dense, Dropout

model = Sequential([
    LSTM(64, input_shape=(30, 1), return_sequences=True),
    Dropout(0.2),
    LSTM(32),
    Dense(1)
])

model.compile(optimizer="adam", loss="mse")
model.fit(X_train, y_train, epochs=20, batch_size=32)
İlk LSTM katmanındaki return_sequences=True, her zaman adımı için çıktı üreterek ikinci LSTM’nin dizinin tamamını görmesini sağlar. Dropout, modelin eğitim verisini ezberleme riskini azaltır. mse ise gerçek ve tahmin edilen sayısal değerler arasındaki karesel farkı ölçer.
LSTM her uzun dizi problemi için otomatik olarak en iyi seçenek değildir. Transformer mimarileri paralel işlem avantajıyla birçok metin görevinde öne çıkarken, LSTM’ler daha küçük veri kümelerinde, akış hâlindeki verilerde ve kaynak kısıtlı zaman serisi uygulamalarında hâlâ güçlü bir araçtır. Asıl sihir, kapıların matematiksel olarak basit ama davranışsal olarak seçici olmasındadır: LSTM, yalnızca hatırlamayı değil, doğru zamanda unutmayı da öğrenir.
Yorumlar