İçindekiler
Tek bir bilgisayarın günlerce uğraşacağı bir veri kümesini yüzlerce makineye paylaştırıp kısa sürede işlemek kulağa sihir gibi gelebilir. MapReduce, bu sihri iki temel adıma indirgeyen klasik bir programlama modelidir: Veriyi bağımsız parçalara ayır, parçaları paralel işle ve sonuçları anlamlı bir bütün hâline getir.
``
MapReduce neden ortaya çıktı?
Milyarlarca web sayfasındaki kelimeleri saymak istediğimizi düşünelim. Verilerin tamamını tek bir makinenin belleğine yüklemek mümkün olmayabilir. Üstelik işlem sırasında donanım arızası yaşanırsa bütün hesaplamayı yeniden başlatmak gerekebilir.
MapReduce bu sorunlara dağıtık hesaplama yaklaşımıyla cevap verir. Veri farklı düğümlere dağıtılır ve aynı işlem her parçada eş zamanlı yürütülür. Teorik olarak veri miktarı $N$, çalışan düğüm sayısı $P$ ise ideal çalışma süresi yaklaşık olarak şöyle düşünülebilir:
\[T_{paralel} \approx \frac{N}{P} + T_{iletisim} + T_{birlestirme}\]Gerçek sistemlerde hızlanma tam olarak $P$ kat olmaz. Çünkü ağ iletişimi, disk erişimi, görev planlama ve sonuçların birleştirilmesi ek maliyet oluşturur.
Üç perdelik veri oyunu
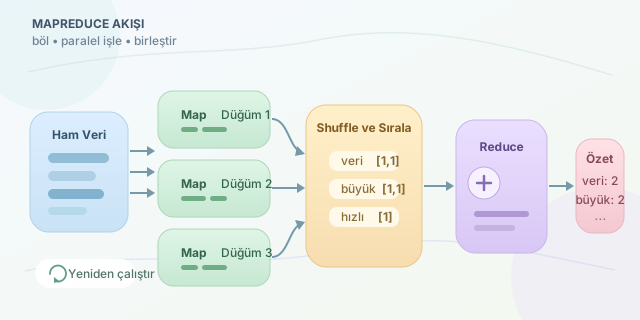
MapReduce akışı aslında Map ve Reduce arasında gerçekleşen önemli bir ara aşamaya sahiptir:
- Map: Girdi kayıtlarını anahtar-değer çiftlerine dönüştürür.
- Shuffle ve Sort: Aynı anahtara ait değerleri aynı işlemciye taşır ve gruplar.
- Reduce: Gruplanmış değerlerden nihai sonucu üretir.
| Aşama | Girdi | Çıktı | Temel görev |
|---|---|---|---|
| Map | Ham kayıt | Anahtar-değer çiftleri | Veriyi bağımsız olarak dönüştürmek |
| Shuffle | Dağınık çiftler | Anahtara göre gruplar | Veriyi ağ üzerinden düzenlemek |
| Reduce | Anahtar ve değer listesi | Özet sonuç | Değerleri birleştirmek |
Kelime sayımı örneğinde Map fonksiyonu gördüğü her kelime için (kelime, 1) üretir. Shuffle aşaması aynı kelimeleri toplar. Reduce ise bu birleri toplar:
Python ile küçük bir benzetim
Aşağıdaki kod gerçek bir Hadoop kümesi kurmaz; fakat modelin mantığını tek makinede görünür hâle getirir:
from collections import defaultdict

metinler = [
    'veri büyük veri hızlıdır',
    'mapreduce büyük veriyi işler'
]

def map_fonksiyonu(metin):
    return [(kelime, 1) for kelime in metin.split()]

ara_sonuclar = []
for metin in metinler:
    ara_sonuclar.extend(map_fonksiyonu(metin))

# Shuffle: Aynı anahtarın değerlerini gruplar.
gruplar = defaultdict(list)
for anahtar, deger in ara_sonuclar:
    gruplar[anahtar].append(deger)

# Reduce: Her kelimenin değerlerini toplar.
sonuc = {
    anahtar: sum(degerler)
    for anahtar, degerler in gruplar.items()
}

print(sonuc)
Burada her metin bağımsız biçimde eşlenebilir. Gerçek bir dağıtık sistemde bu metin parçaları farklı makinelerde bulunur. Çerçeve; görev dağıtımı, başarısız işlerin yeniden çalıştırılması ve ara sonuçların taşınması gibi operasyonel ayrıntıları programcıdan büyük ölçüde saklar.
MapReduce ve klasik paralellik
| Özellik | MapReduce | Paylaşımlı bellek paralelliği |
|---|---|---|
| Veri konumu | Birçok makineye dağılmıştır | Genellikle aynı makinededir |
| İletişim | Ağ ve anahtar-değer aktarımı | Ortak bellek |
| Hata toleransı | Görev yeniden çalıştırılabilir | Uygulamaya bağlıdır |
| Uygun iş yükü | Büyük, toplu veri işleme | Düşük gecikmeli hesaplamalar |
MapReduce özellikle günlük analizi, arama indeksi oluşturma ve büyük ölçekli toplulaştırma işlemlerinde başarılıdır. Buna karşılık makine öğrenmesindeki yinelemeli algoritmalar veya gerçek zamanlı sorgular için her turda diske yazma maliyeti can sıkıcı olabilir. Bu nedenle Apache Spark gibi sistemler verileri bellekte tutarak bazı iş yüklerini hızlandırmıştır.
Gücü sadeliğinde
MapReduce’un en değerli fikri belirli bir ürün değil, hesaplamayı bağımsız dönüşümlere ve birleştirmelere ayırmasıdır. Her problem bu kalıba uymaz; ancak uyduğunda yatay ölçekleme, hata toleransı ve paralellik daha yönetilebilir olur. Kısacası MapReduce, dev bir işi tek kahramana vermek yerine düzenli çalışan bir veri ekibi kurar.
Yorumlar