İçindekiler
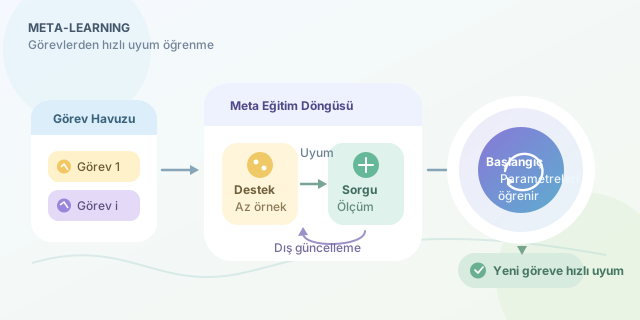
Geleneksel makine öğrenmesinde her yeni problem için veri toplar, modeli eğitir ve sabırla sonuç bekleriz. Meta-learning ise bu rutine küçük bir itiraz getirir: Model yalnızca görevleri çözmesin, yeni bir görevi nasıl hızlı öğreneceğini de keşfetsin. Böylece binlerce örnek yerine birkaç örnekle uyum sağlayabilen, deyim yerindeyse eğitim salonunda nasıl antrenman yapacağını öğrenen sistemler ortaya çıkar.
``
Fikir nereden çıktı?
“Öğrenmeyi öğrenme” düşüncesi yapay zekâdan daha eskidir. Psikoloji, insanların önceki deneyimlerinden yararlanarak yeni becerileri daha hızlı kazandığını uzun süredir inceliyordu. Makine öğrenmesinde ise erken dönem çalışmalar, algoritmaların kendi öğrenme kurallarını ayarlayıp ayarlayamayacağı sorusuna odaklandı.
1990’larda sinir ağlarının ağırlık güncellemelerini başka ağlarla yönetme fikri belirginleşti. 2000’lerde çoklu görev öğrenmesi ve aktarım öğrenmesi güçlü temeller sağladı. 2010’ların ortasında derin öğrenme, büyük veri kümeleri ve GPU’larla birleşince meta-learning uygulanabilir hâle geldi. 2016 tarihli Matching Networks ve 2017’de yayımlanan MAML, alanın en etkili dönüm noktaları arasında yer aldı.
| Yaklaşım | Temel amaç | Yeni görevde gereken |
|---|---|---|
| Klasik eğitim | Tek görevi iyi çözmek | Çok veri ve yeniden eğitim |
| Transfer learning | Önceden öğrenilmiş özellikleri aktarmak | İnce ayar ve orta miktarda veri |
| Few-shot learning | Birkaç örnekle tahmin yapmak | Küçük destek kümesi |
| Meta-learning | Uyum sağlama sürecini öğrenmek | Birkaç örnek ve az sayıda güncelleme |
Görevler üzerinden öğrenmek
Normal eğitimde veri noktaları örneklenir. Meta-learning eğitiminde ise görevler örneklenir. Her görev genellikle iki parçaya ayrılır:
- Destek kümesi: Modelin göreve uyum sağladığı az sayıdaki örnek.
- Sorgu kümesi: Uyumun gerçekten işe yarayıp yaramadığını ölçen örnekler.
Bir görev $T_i$ için destek kaybı $L_{S_i}$ olsun. Modelin başlangıç parametreleri $θ$ ise tek adımlık uyarlama şöyle yazılabilir:
\[θ'_i = θ - α ∇_θ L_{S_i}(θ)\]Burada $α$ iç döngünün öğrenme oranıdır. Meta-model, uyarlanmış parametrelerin sorgu kümelerindeki toplam hatasını azaltmaya çalışır:
\[min_θ Σ_i L_{Q_i}(θ'_i)\]İşin sihri burada yatar: Sistem yalnızca doğru cevabı değil, birkaç gradyan adımından sonra iyi sonuç verecek bir başlangıç noktası öğrenir. MAML’ın modelden bağımsız sayılmasının nedeni de bu fikrin sınıflandırma, regresyon veya pekiştirmeli öğrenme gibi farklı alanlara uygulanabilmesidir.
Üç ana meta-learning ailesi
| Aile | Öğrendiği şey | Bilinen örnek |
|---|---|---|
| Optimizasyon tabanlı | Hızlı uyarlanabilir parametreler | MAML, Reptile |
| Metrik tabanlı | Örnekler arasındaki benzerlik uzayı | Prototypical Networks |
| Model tabanlı | Bellek veya öğrenme mekanizması | Memory-Augmented Networks |
Metrik tabanlı yöntemlerde her sınıfın prototipi hesaplanabilir. $k$ sınıfına ait destek temsillerinin ortalaması:
\[c_k = (1 / \vert S_k\vert ) Σ_{x ∈ S_k} f_θ(x)\]Yeni örnek, temsili hangi $c_k$ noktasına daha yakınsa o sınıfa atanır. Bir bakıma model, “Bu fotoğraf hangi aile albümüne daha çok benziyor?” diye sorar.
MAML mantığının küçük bir kod karşılığı
Aşağıdaki PyTorch taslağı, tek görev için iç güncelleme yapar ve sorgu kaybını hesaplar. create_graph=True, dış döngünün iç güncelleme üzerinden türev alabilmesini sağlar:
import torch
from torch.func import functional_call

support_logits = model(x_support)
support_loss = loss_fn(support_logits, y_support)

params = dict(model.named_parameters())
grads = torch.autograd.grad(
    support_loss,
    params.values(),
    create_graph=True
)

fast_params = {
    name: param - inner_lr * grad
    for (name, param), grad in zip(params.items(), grads)
}

query_logits = functional_call(model, fast_params, (x_query,))
outer_loss = loss_fn(query_logits, y_query)

optimizer.zero_grad()
outer_loss.backward()
optimizer.step()
Gerçek uygulamada bu işlem birçok görev için tekrarlanır ve sorgu kayıpları ortalanır. Hesaplama maliyeti özellikle ikinci dereceden türevler nedeniyle yükselebilir; First-Order MAML ve Reptile gibi yöntemler bu yükü azaltmayı hedefler.
Neden önemli?
Meta-learning; nadir hastalıkların sınıflandırılması, yeni robot hareketleri, kişiselleştirilmiş öneriler ve az kaynaklı diller gibi verinin pahalı olduğu alanlarda değerlidir. Yine de görev dağılımı kötü seçilirse model yeni koşullara uyum sağlayamaz. Kısacası öğrenmeyi öğrenen bir sistem de öğretmeninin hazırladığı müfredat kadar iyidir. Meta-learning’in büyük vaadi, her şeyi bilen modeller değil; bilmediği bir şeyle karşılaştığında ne yapacağını daha çabuk anlayan modeller üretmesidir.
Yorumlar