İçindekiler
Mikroservis mimarisinde tek bir kullanıcı isteği, çoğu zaman API Gateway’den başlayıp kimlik doğrulama, katalog, ödeme, stok ve bildirim servisleri arasında dolaşır. Bir sayfanın üç saniyede açılması can sıkıcıdır; fakat asıl zor soru şudur: Bu üç saniyeyi hangi servis, hangi veritabanı sorgusu veya hangi ağ çağrısı tüketti? Distributed tracing, isteğin yolculuğunu uçtan uca görünür hâle getirerek tahmin oyununu ölçülebilir bir performans araştırmasına dönüştürür. ``
Trace, span ve bağlam ilişkisi
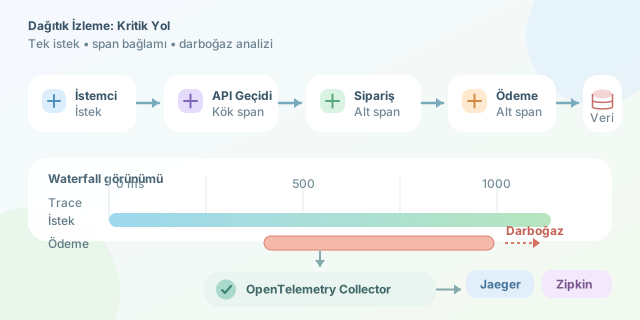
Distributed tracing’in temel nesnesi trace’tir: Tek bir kullanıcı isteğine ait tüm operasyonların ağacıdır. Trace içindeki her zamanlanmış iş parçasına span denir. Örneğin checkout isteğinde gateway, sipariş servisi, ödeme servisi ve PostgreSQL sorgusu ayrı span’ler oluşturabilir. Her span; başlangıç zamanı, süre, etiketler, hata bilgisi ve ebeveyn span kimliği taşır.
Bir span’in toplam süresi, alt çağrıların süreleri ile yerel işlem maliyetinden oluşur. Basitleştirilmiş biçimde:
\[T_{span} = T_{yerel} + \sum T_{bekleme} + \sum T_{alt\ çağrı}\]Ancak paralel çalışan çağrılarda süreler toplanmaz; kritik yol belirleyicidir. Kullanıcının hissettiği gecikme yaklaşık olarak şöyledir:
\[T_{istek} \approx \max(\text{kritik yol üzerindeki span süreleri})\]Bu nedenle iki servisin paralel olarak 300 ms ve 500 ms sürmesi, isteğe 800 ms değil yaklaşık 500 ms ekler. Tracing arayüzündeki waterfall görünümü, bu kritik yolu gözle yakalamanın en pratik yoludur.
Jaeger ve Zipkin karşılaştırması
Her iki araç da trace toplar, depolar ve görselleştirir. Seçim; ekosistem, operasyonel ihtiyaçlar ve gözlemlenebilirlik yaklaşımına bağlıdır.
| Özellik | Jaeger | Zipkin |
|---|---|---|
| Köken | Uber tarafından geliştirildi | Twitter tarafından geliştirildi |
| Arayüz | Güçlü trace arama ve servis bağımlılık görünümü | Sade, hızlı ve minimal arayüz |
| OpenTelemetry uyumu | Yaygın ve güçlü | OpenTelemetry ile kullanılabilir |
| Depolama seçenekleri | Elasticsearch, Cassandra, Kafka gibi seçenekler | Elasticsearch, MySQL, Cassandra gibi seçenekler |
| İdeal kullanım | Büyük dağıtık sistemler, ayrıntılı analiz | Basit kurulum, hafif tracing ihtiyacı |
Güncel projelerde en güvenli enstrümantasyon tercihi genellikle OpenTelemetry’dir. Uygulamanızı doğrudan tek bir araca bağlamak yerine OpenTelemetry SDK ve Collector kullanırsanız, Jaeger’dan başka bir backend’e geçmek daha az sancılı olur.
Python ile span üretmek
Aşağıdaki örnek, Flask tabanlı bir serviste gelen isteği ve ödeme çağrısını span olarak işaretler. Exporter yapılandırması ortam değişkenleri veya OpenTelemetry Collector üzerinden yapılabilir.
from flask import Flask, jsonify
from opentelemetry import trace
from opentelemetry.instrumentation.flask import FlaskInstrumentor

app = Flask(__name__)
FlaskInstrumentor().instrument_app(app)
tracer = trace.get_tracer("order-service")

@app.get("/checkout/<order_id>")
def checkout(order_id):
    with tracer.start_as_current_span("validate-order") as span:
        span.set_attribute("order.id", order_id)
        valid = True

    with tracer.start_as_current_span("payment-request") as span:
        span.set_attribute("payment.provider", "bank-x")
        # HTTP istemcisiyle ödeme servisine çağrı yapılır.
        payment_status = "approved"

    return jsonify({"valid": valid, "payment": payment_status})
Flask enstrümantasyonu HTTP sunucu span’ini otomatik oluşturur. Elle eklenen span’ler ise iş kurallarını görünür kılar. order.id gibi alanlar hata ayıklamada değerli olsa da e-posta, kart numarası ve token gibi hassas veriler trace etiketlerine asla yazılmamalıdır.
Darboğazı sistematik biçimde bulmak
Önce yavaş istekleri süreye göre filtreleyin; ardından trace içindeki en uzun span’i değil, kritik yol üzerindeki en uzun beklemeyi inceleyin. Yüksek gecikmeye hata oranı, servis adı ve endpoint etiketiyle birlikte bakmak yanlış alarmları azaltır.
| Trace bulgusu | Olası neden | İlk aksiyon |
|---|---|---|
| Veritabanı span’i uzun | Eksik indeks veya ağır sorgu | Sorgu planını incele, indeks doğrula |
| HTTP istemci span’i uzun | Uzak servis yavaş veya ağ sorunu | Timeout, retry ve bağımlı servis metriklerini kontrol et |
| Çok sayıda kısa span | N+1 çağrı deseni | Toplu endpoint veya cache tasarla |
| Kuyrukta bekleme yüksek | Tüketici kapasitesi yetersiz | Consumer sayısını ve mesaj işleme süresini ölç |
Son olarak sampling stratejisini unutmayın. Her isteği kaydetmek yüksek trafikte maliyetlidir. Hata içeren veya yavaş trace’leri daha yüksek oranda örnekleyen tail-based sampling, hem depolama maliyetini kontrol eder hem de performans soruşturmalarında gerekli kanıtları saklar.
Yorumlar