Satranç oynayan bir programın milyonlarca olasılık arasından mantıklı bir hamle seçmesi sihir değildir; rakibin de mümkün olan en iyi karşılığı vereceğini varsayan sistematik bir aramadır. Minimaks, iki oyunculu ve sıfır toplamlı oyunlarda bu düşünceyi modele dönüştürür. Alfa-beta budama ise sonucu değiştirmeyecek dalları erkenden eleyerek aynı karara çok daha az hesaplamayla ulaşır.
``
Oyun Ağacının Temel Mantığı
Bir oyun durumu ağacın düğümünü, yapılabilecek hamleler ise dalları temsil eder. Oyuncular sırayla hareket eder:
- MAX, değerlendirme puanını büyütmeye çalışır.
- MIN, aynı puanı küçültmeye çalışır.
- Yaprak düğümler, oyunun bittiği veya belirlenen arama derinliğine ulaşıldığı konumlardır.
Sıfır toplamlı bir oyunda bir oyuncunun kazancı diğerinin kaybıdır. Örneğin MAX açısından galibiyet $+1$, beraberlik $0$, mağlubiyet $-1$ olabilir. İdeal minimaks değeri şöyle tanımlanır:
\[V(s)= \begin{cases} U(s), & \text{eğer } s \text{ terminal durumsa} \\ \max\limits_{c \in C(s)} V(c), & \text{MAX sırasıysa} \\ \min\limits_{c \in C(s)} V(c), & \text{MIN sırasıysa} \end{cases}\]Burada $C(s)$ durumun çocuklarını, $U(s)$ ise sonuç veya sezgisel değerlendirme puanını gösterir. Algoritma önce aşağı iner, ardından değerleri yapraklardan köke doğru taşır. Kısacası MAX iyimser, MIN ise bu iyimserliği bozmaya kararlı rakiptir.
| Özellik | Minimaks | Alfa-beta budamalı minimaks |
|---|---|---|
| Bulduğu sonuç | En iyi hamle | Aynı en iyi hamle |
| Budama | Yok | Gereksiz dallar elenir |
| En kötü karmaşıklık | $O(b^d)$ | $O(b^d)$ |
| İyi hamle sıralamasında | $O(b^d)$ | Yaklaşık $O(b^{d/2})$ |
| Bellek ihtiyacı | Derinliğe bağlı | Genellikle benzer |
Tablodaki $b$ ortalama dallanma sayısını, $d$ arama derinliğini belirtir. Budama en kötü durumda mucize yaratmaz; fakat iyi sıralanmış hamlelerde erişilebilen derinliği neredeyse iki katına çıkarabilir.
Alfa ve Beta Ne Söylüyor?
Arama sırasında iki sınır tutulur:
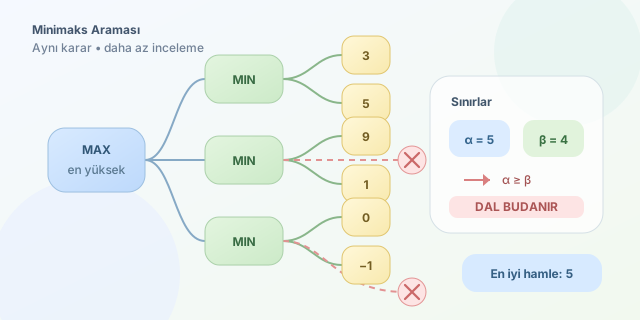
- Alfa ($\alpha$): MAX oyuncusunun şimdiye kadar garanti ettiği en yüksek değer.
- Beta ($\beta$): MIN oyuncusunun şimdiye kadar garanti ettiği en düşük değer.
Bir düğümde $\alpha \geq \beta$ olduğunda kalan çocuklar incelenmez. Çünkü üst seviyedeki oyuncu bu dala zaten izin vermeyecektir. Bu işlem yaklaşık sonuç üretmez; yalnızca karar üzerinde etkisi olmayacağı matematiksel olarak bilinen seçenekleri atlar.
Örneğin MIN düğümü daha önce değeri $4$ olan bir seçenek bulmuş olsun. Yeni dalın ilk çocuğu $6$ üretse bile araştırma sürebilir. Ancak bu dal MAX düğümüyse ve değer en az $7$ olduysa, MIN zaten daha küçük olan $4$ seçeneğine dönecektir. Dalın geri kalanında $9$ veya $900$ bulunması kararı değiştirmez.
Python ile Uygulama
Aşağıdaki fonksiyon, ağacı iç içe listelerle temsil eder. Sayılar yaprak puanlarıdır; maximizing sıradaki oyuncuyu belirler.
def alpha_beta(node, depth, alpha, beta, maximizing):
    # Sayıya veya derinlik sınırına ulaşıldığında puanı döndürür.
    if depth == 0 or isinstance(node, (int, float)):
        return node

    if maximizing:
        value = float("-inf")
        for child in node:
            value = max(
                value,
                alpha_beta(child, depth - 1, alpha, beta, False)
            )
            alpha = max(alpha, value)
            if alpha >= beta:  # Beta kesmesi
                break
        return value

    value = float("inf")
    for child in node:
        value = min(
            value,
            alpha_beta(child, depth - 1, alpha, beta, True)
        )
        beta = min(beta, value)
        if alpha >= beta:  # Alfa kesmesi
            break
    return value

agac = [[3, 5, 6], [9, 1, 2], [0, -1, 7]]
sonuc = alpha_beta(agac, 2, float("-inf"), float("inf"), True)
print(sonuc)
Gerçek oyunlarda yapraklarda hazır sayılar bulunmaz. Taş avantajı, hareket özgürlüğü, merkez kontrolü veya güvenli konum gibi özellikler ağırlıklandırılır:
\[E(s)=w_1m+w_2h+w_3g\]Burada $m$ materyal, $h$ hareketlilik, $g$ güvenlik puanı olabilir. Güçlü bir değerlendirme fonksiyonu ve iyi hamle sıralaması, budamanın etkisini ciddi biçimde artırır. Böylece program her olasılığı düşünmek yerine gerçekten önemli olasılıklara odaklanır; tıpkı deneyimli bir oyuncunun saçma hamleleri masaya bile getirmemesi gibi.
Yorumlar